Day 30:結賽 — 2026 之後的 AI 人才養成之路
· 閱讀時間約 7 分鐘
30 天前,本系列從一份 AI 新興職缺資料出發,說市場已經分成兩個職務。29 天後,我們把這兩個職務的每一項工作任務都拆解、實作、並討論了取捨。
今天做三件事:回顧這條路徑的核心主張、檢討這個系列的限制、給三種讀者各一張路線圖。
30 天前,本系列從一份 AI 新興職缺資料出發,說市場已經分成兩個職務。29 天後,我們把這兩個職務的每一項工作任務都拆解、實作、並討論了取捨。
今天做三件事:回顧這條路徑的核心主張、檢討這個系列的限制、給三種讀者各一張路線圖。
28 天的技術內容結束了。今天處理最後一哩:怎麼讓別人相信你會這些。
這篇的內容比較「不技術」,但如果你的目標是轉職或升遷,它可能是投報率最高的一天。
前 27 天,我們一塊一塊地拆解了兩個職務的工作任務。今天要把它們組裝回一個完整的東西。
這也是我對每位讀者的建議:與其收藏 27 篇文章,不如做出一個作品。。
技術面完成了,今天處理制度面——也是這個系列裡最容易被工程師跳過、卻最可能決定專案生死的一天。
昨天談的是「怎麼做得又快又便宜」,今天談的是「怎麼確保這件事做得下去」。
昨天讓系統「品質可測」,今天讓它「不會闖禍」。
這一天的內容有個特性:平常沒有人在意,出事一次就記得一輩子。它是 Day 22 那五道護欄的理論基礎,也是 Day 27 治理的技術面。
⚖️ 前提聲明
本文所有攻擊手法的說明,僅以防禦與合法授權測試為目的。文中的紅隊演練請務必在你自己擁有或已取得書面授權的系統上進行。未經授權對他人系統進行測試,於我國《刑法》妨害電腦使用罪章可能構成犯罪。
今天是合流點。前十六天兵分兩路,從今天起的四天,兩條路的人都要看——因為評測、安全、LLMOps、治理,是兩個職務共同的責任。
而評測是其中最關鍵的:它是「做得出 demo」與「做得出產品」的分界線。
主軸二的最後一個技術主題。前七天我們讓模型「知道」(RAG)、「能做」(Agent),今天讓它「像我們要的樣子」。
我把微調放在最後,是刻意的——因為它是最後才該考慮的手段。
昨天手刻了 ReAct 迴圈,也給了兩個護欄(迭代上限、成本上限)。今天處理讓它能真正上線的三件事:工具怎麼接得可維護、多代理什麼時候值得、怎麼確保它不會闖禍。
RAG 讓模型「知道」,Agent 讓模型「能做」。今天進入第二高頻的任務訊號(47.6%)。
但我要先講一個可能讓你意外的建議:你需要的多半不是 Agent。
昨天說明文件的索引,今天處理:怎麼把對的東西找出來。
今天說明的混合檢索、重排序、查詢改寫等3個技術是實務上 CP 值最高的三個優化,而且都不需要換模型。
今天進入生成式 AI 職缺中出現頻率最高的主題:RAG(48.1%)。
因為它太重要,我用三天處理:今天講索引端(文件怎麼進去)、明天講檢索端(怎麼找出來)、後天講生成與評測(怎麼用、怎麼知道好不好)。
如果你只能讀一天,讀今天——因為多數 RAG 系統的品質上限,在文件進資料庫的那一刻就決定了。
2020 年我初次參加鐵人賽寫的是《用 LINE 串起多媒體系統》(GitHub),那 30 天在做的事,本質上是:接收使用者訊息 → 判斷意圖 → 呼叫對應的服務 → 組裝回應。
六年後的今天,我們做的事情架構上驚人地相似,但有一件根本性的不同:
2020 年,「判斷意圖」是我用
if "天氣" in text寫死的。 2026 年,這件事由模型決定,而且它還會自己決定要呼叫哪個 API、帶什麼參數。這一行差別,就是今天的主題。
今天進入主軸二:生成式 AI。前八天我們在解決關於 MLOps 的「模型會不會掛」,接下來八天解決「模型會不會智商下線」。
主軸一的讀者會發現,這邊的問題同樣需要工程紀律,只是換了一種形式。
前七天,我們一路處理模型如何可靠地上線、持續部署、監控,以及出問題時怎麼發現。今天換一個主管通常更有感的問題:
這套 AI 系統,到底花多少錢?
模型能活著還不夠,還要活得起。如果工程師只能回答「這樣架構比較漂亮」,很難推動決策;但如果能回答:「這個方案每月多花多少?」、「GPU 利用率提升後,可以少買幾張卡?」、「租雲端和買地端的成本交叉點在哪?」對話就完全不同了。
先看兩個很常見的情境。
場景一
主管:「我們要不要買 GPU?一直租雲端好貴。」 工程師:「呃……我算一下?」
然後這個問題被擱置了三個月。
場景二 主管:「上季買的四張 A100,用得如何?」
工程師:「都有在用啊。」
主管:「利用率多少?」
工程師:「……」
這兩題沒有放諸四海皆準的答案,但有一套可以量化的決策方式。
今天就處理兩個數字:
📊 職缺訊號
「AI/ML 平臺與基礎設施」是這次 MLOps 職缺中最高頻的任務訊號之一,占 58.5%。
不過 JD 的層次差異很大:初階可能寫「維護 GPU 環境」,資深職缺則會出現「規劃 AI 運算資源」、「容量管理」、「平臺工程」與「成本最佳化」。
分水嶺不只是會不會架環境,而是能不能把技術選擇轉成容量、成本與風險的決策。
昨天服務跑起來了。今天回答:它跑得好不好?
面試時很容易被問到的題目,包含「你的服務延遲多少」、「怎麼提升吞吐」及「P99 為什麼重要」?這三題答得好,入職的機率大大提升。
今天進入 MLOps 職缺中出現頻率最高的領域:AI/ML 平臺與基礎設施(58.5%)。
本日不包含 Kubernetes 的全部——那是一本書的量,而且新入職的你優先事項不包含建立叢集(Day 04 的止損點清單裡有說明)。今天只講跑 ML 工作負載時,與跑一般 Web 服務不一樣的那些地方。
昨天資料有了版本。今天處理另外兩根柱子:這次訓練用了什麼設定、跑出什麼結果、產出的模型在哪裡。
這是 Day 08 診斷表第 3、5 題的內容,也是導入成本最低、痛感解除最快,投資報酬率最高的一天。
昨天的成熟度診斷中,其中「訓練前自動檢查資料」與「重現三個月前的訓練」應是最多團隊答「否」的兩題。今天就處理這兩題。
Day 06 說過可重現需要五根柱子,今天說明資料版本與隨機種子這根支柱,也順便處理一個棘手的問題。
2021 年那套成熟度模型,在 2026 年還適用嗎? 我的答案是:框架適用,內容要改寫。
本系列為 MLOps × GenAI Engineering 雙主軸,走主軸二的讀者可以略讀,但建議至少看完第二節——那是你未來合作對象的世界觀。
今天也是這個系列與 2021 年《從 AI 落地談 MLOps》 正面對話的一天。
今天只聚焦在 Token 怎麼計價、生成怎麼進行、模型怎麼選這三件事,會直接影響你系統設計與帳單,也可能導致容易做出錯誤架構決策的部分。
本篇不會重講 Transformer 的數學(網路上已有太多好文章)。加上前兩天說明了「工程」與「ML」,今天說明「LLM」進行打底。
ML 專案跟一般軟體專案,到底哪裡不一樣?,在開發環境的建立之後,今天要處理 ML 系統成敗的認知問題。
「在我電腦上明明跑得起來啊。」
這句熟悉的對話日常,在 ML 系統會是場災難,因為 ML 多了兩個變數:資料與模型權重。第一部曲我們將 AI 職缺目前在市場的需求進行說明,第二部曲聚焦在地基,今天要做的,就是降低只能回答出「在我電腦上明明可以」的風險。
三天下來我們確認了:市場要什麼(Day 02)、誰負責什麼(Day 03)。今天是第一部曲的收尾,也是我覺得最實用的一篇——把職缺梳理成您能照著走的路。
昨天我們確認了就業市場的徵才概況。今天要處理一個很多人心裡的疑問:這些事,不是資料科學家、DevOps、後端本來就在做的嗎?為什麼要多兩個職務?
這個問題很好,而且答錯的代價很實際——它決定了您面試時該強調什麼、進團隊後該對齊誰、以及出事時該誰負責。
昨天提到,這一系列文章是從真實需求出發,透過整理新興 AI 職缺,我觀察到目前市場上的 AI 人才需求,已逐漸分化成兩類不同的職務方向。今天,就想進一步和大家分享我從職缺資料中看到的變化與趨勢。
透過實際職缺的觀察,再對照過去 MLOps 發展至今的市場變化,我更希望把這些真實世界中的人才需求,重新扣回到一個最實際的問題:如果我們想成為 AI Engineer,現在究竟該如何準備?
2021 年,我在鐵人賽寫了《從 AI 落地談 MLOps》(GitHub)。那 30 天在回答一個問題:模型訓練好了,然後呢?
五年後,這個問題不但沒有過期,還變得更尖銳了——因為現在連「訓練模型」這件事,仍不是大眾的選項,很多團隊任務不再於訓練模型,而是直接呼叫 API,兩週做出一個看起來很厲害的 Demo,然後卡在同一個地方:上不了線,或者上線了沒人知道它是好是壞。
這 30 天,我想用一個不太一樣的方式重新回答 AI 落地:不從技術出發,而是從職缺出發。
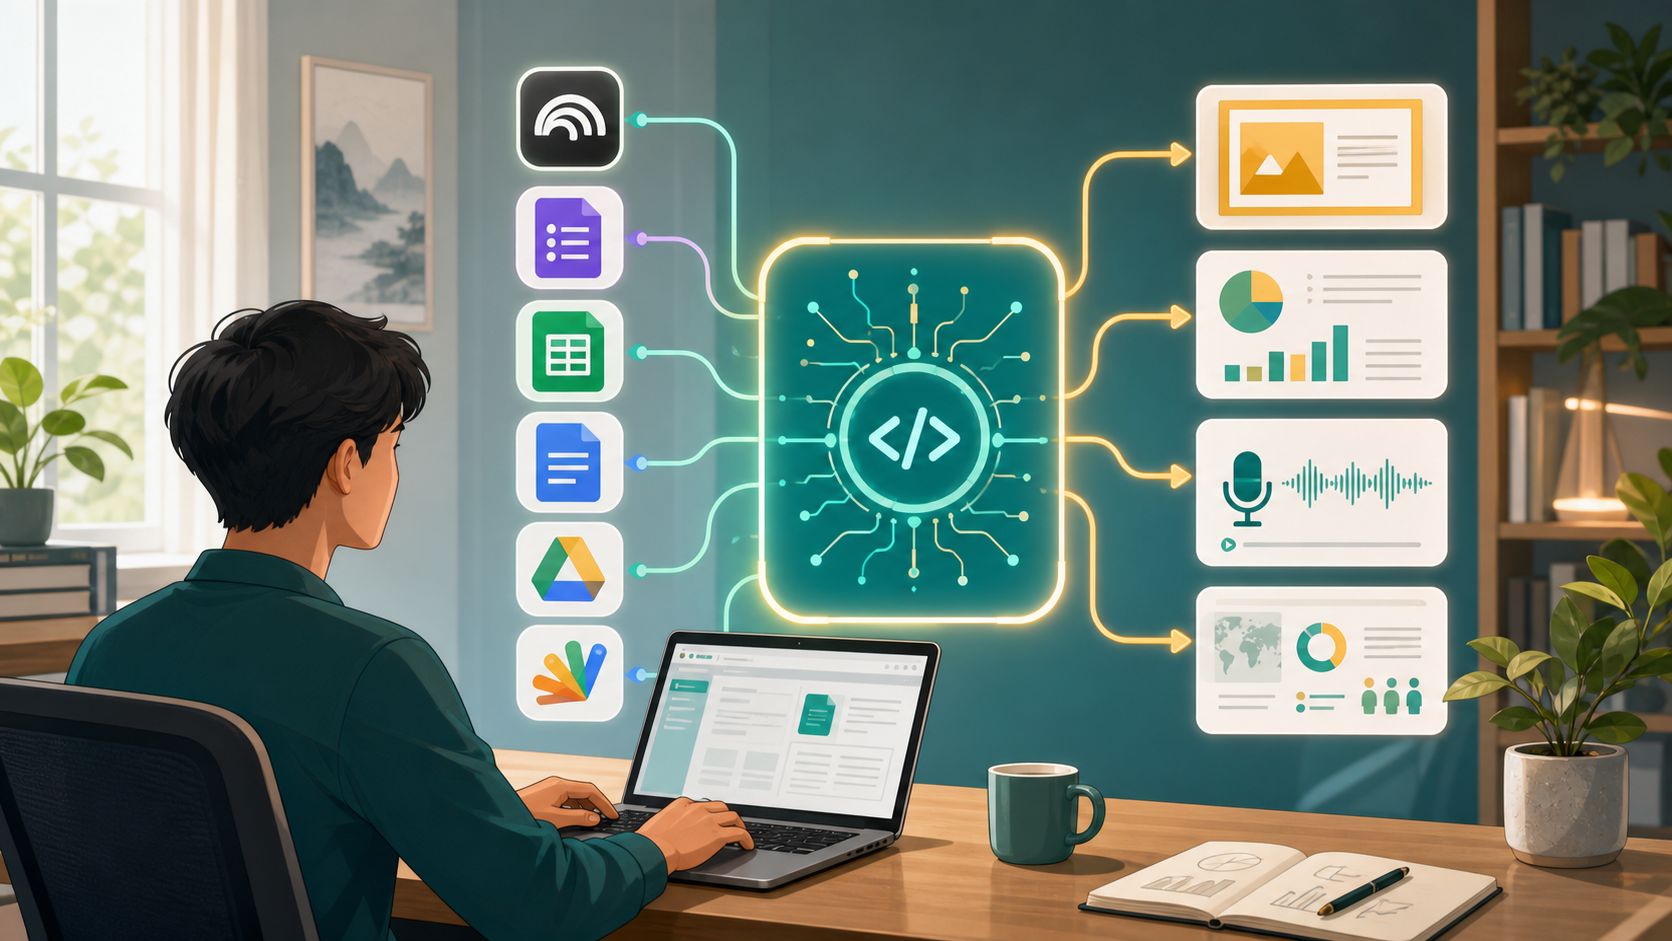
很多人使用 AI 工具時,第一個困難其實不是「不會下指令」,而是還沒把問題說清楚。
例如:
這些想法都合理,但如果直接要求 AI 產出成品,常常會得到一份看起來漂亮、實際上不好落地的答案,特別是我在教學、顧問的經驗之中,在沒有很有效的框架思考之下,時常需要進一步的釐清與討論。
所以我整理了一個公開 Codex Skill:
https://github.com/willismax/notebooklm-workflow-coach
它的目標不是替你按一個魔法按鈕,而是陪你把一個模糊情境,整理成可以執行、可以查證、可以重複使用的 NotebookLM + Google Workspace 工作流,而這個工作流是基於一套系統化的思考框架、落實為6周訓練課程後得到的歸納與實踐成果。
用 GAS 打造專屬 LINE AI 課程助教,整合 Gemini、上下文記憶與 Google 試算表 QA 知識庫

在「職場 AI 加速術」的課程裡,我們已經學會怎麼用 Google 表單收資料、用 Google 試算表整理數據,也知道如何把教材丟進 NotebookLM 建立知識庫。但如果學員半夜傳訊息來問問題,難道真的要靠老師 24 小時守在螢幕前一題一題回嗎?
這篇文章要帶你用 Google Apps Script(GAS)結合 LINE Messaging API、Google Gemini,以及 Google 試算表,做出一個真正能上線的 LINE 課程 AI 助教。它不只會回答問題,還能保留短期上下文、讀取 QA 知識庫、解析學員上傳的錯誤截圖,並把對話紀錄自動寫回試算表,讓你後續能回頭分析學員最常卡住的地方。
更重要的是,這個助教不是只有「會講話」而已,而是被設計成盡量不要亂講話。你可以把課程常見問答、報名網址、課綱資訊都放進 Google 試算表,讓助教每次回答前先參考你的標準答案,再透過 LINE Flex Message 以更專業的方式呈現給學員。

如果你是第一次碰 LINE Bot,建議先看我之前寫的用 HackMD API 打造個人專屬 LINE BOT 助手,那篇比較偏 LINE Developers、Channel、Webhook 與 Token 的入門流程。若你關心的是「AI 助教要怎麼設計角色與教學互動」,也可以搭配客製化你的 AI 教學助手:蘇格拉底引導教學法一起看。

圖:學員從 LINE 提問後,GAS 負責串接 Gemini、Google 試算表與 Flex Message 回覆。

這次的版本不只是單純的聊天機器人,而是加入了幾個在教學現場很實用的能力:
如果你想做的是「課程助教型」機器人,而不是一個什麼都會答、但很容易亂掰的聊天機器人,這個架構會很適合你。


在開始貼程式碼之前,先準備以下資源:
這個專案會碰到三種敏感資訊:LINE Channel Access Token、Gemini API Key,以及 Google 試算表 ID。尤其前兩者一旦外洩,別人就可能拿你的額度呼叫 API,甚至冒用你的 LINE Bot 回覆訊息。
所以實作時請記住幾個原則:
在 GAS 裡比較實用的做法,是把密鑰放到「指令碼屬性(Script Properties)」裡,再由程式讀取。這樣至少不會讓密鑰直接出現在程式碼畫面中,也比較不容易在複製教學範例時一起外流。

圖:真正的 API Key 放在 Script Properties,程式碼只負責讀取,不把鑰匙寫死在範例中。
先新建一份 Google 試算表,接著觀察網址列,複製 /d/ 到 /edit 中間那段英數字,這就是你的 Spreadsheet ID,等等會用到。
接著在這份試算表底下建立兩個工作表:
時間、學員LINE ID、學員提問、AI解答常見問題、標準解答為了讓助教一上線就具備課程背景,你可以先把以下 61 筆 QA 直接貼進 QA知識庫 工作表。這份資料同時涵蓋 NotebookLM、課程架構與常見實作疑問,能讓回覆更穩定。
常見問題	標準解答
1. 什麼是 NotebookLM?	Google 開發的 AI 驅動筆記工具,核心應用是協助使用者整理、分析各種資料,並從中「蒸餾」知識。
2. NotebookLM 跟一般聊天 AI(如 ChatGPT)差在哪裡?	NotebookLM 是基於 RAG 技術,會根據你上傳的專屬資料來回答,並附上原文引用出處,大幅減少 AI 亂編造的幻覺。
3. NotebookLM 的核心模型是什麼?	採用先進的 Gemini 1.5 Pro 大型語言模型,擁有 2M 超大上下文視窗。
4. 把機密資料上傳到 NotebookLM 安全嗎?	上傳到個人 NotebookLM 的資料不會被用來訓練 Google 的通用模型。但若含信用卡、未公開個資等極高機密,仍建議先脫敏或避免上傳雲端。
5. NotebookLM 適合用來取代 Notion 嗎?	不適合。NotebookLM 不是專業的傳統筆記排版軟體,不該把時間花在美化筆記上,而是用來快速萃取大量資料的重點。
6. 一個筆記本最多可以上傳多少份來源文件?	每個筆記本最多可包含 50 個來源文件(Source)。
7. 單一來源文件的容量限制是多少?	每份來源最多可包含 50 萬字元,或檔案大小上限 200MB。
8. 上傳來源文件後可以修改內容嗎?	來源加入之後無法直接編輯,只能刪除後重新加入修改好的檔案。
9. 每個筆記本可以建立多少份記事(Notes)?	最多可包含 1,000 份記事,每份最多包含 99,993 字。
10. NotebookLM 支援上傳哪些檔案格式?	支援 pdf、txt、md、Google 文件、Google 簡報、網頁網址、YouTube 網址,以及多種音訊檔(mp3、wav、m4a 等)。
11. 可以直接上傳 Excel 或 Word 檔嗎?	目前不支援 .xlsx 格式。遇到試算表資料,請先貼成純文字、轉為 Google 文件或 PDF 格式後再匯入。
12. YouTube 影片都能直接匯入嗎?	僅支援有字幕的公開影片。新上傳影片需等待 72 小時後才能匯入,且不支援無語音影片。
13. 如果 YouTube 影片無法匯入怎麼辦?	建議使用第三方字幕下載工具(如 DownSub)將字幕下載成文字檔,再上傳到 NotebookLM。
14. NotebookLM 可以閱讀圖片嗎?	目前對僅含圖片的 PDF 解析能力有限。建議先透過 OCR 軟體(如 PDF-XChange)將圖片掃描轉成文字後再匯入。
15. 遇到 SPA 動態網頁無法匯入怎麼辦?	可利用 Jina Reader API 或 MarkDownload 等擴充功能,先將網頁內容轉為 Markdown 格式再匯入。
16. 怎麼把實體書本匯入 NotebookLM?	需要先裁書並掃描成 PDF,接著用光學字元辨識(OCR)技術把圖片轉為可複製的文字,最後再匯入。
17. 電子書(EPUB)格式可以匯入嗎?	建議先透過工具將 EPUB 轉成 Word,再轉為 Google Docs 格式匯入,這樣能保留完整的文字結構上下文。
18. 怎麼把會議錄音轉化為知識庫?	錄音檔可直接匯入 NotebookLM,系統會自動處理語音。若要更準確,建議同時匯入會議的相關文件作為上下文補充。
19. LINE 或群組的聊天紀錄可以分析嗎?	可以。將 LINE 聊天紀錄匯出為文字檔(.txt)上傳,就能請 AI 分析事件來龍去脈、決策過程或進行人物側寫。
20. 要怎麼讓 NotebookLM 分析 GitHub 程式碼專案?	善用 repo2txt 或 Repomix 等工具,將整個 Repo 打包成一個 AI 友好的單一純文字檔後再上傳。
21. 當上傳的 PDF 超過 50 萬字限制時怎麼辦?	請將 PDF 檔拆分成上集、下集等多份檔案,再分別作為獨立來源匯入同一個筆記本。
22. 什麼是「筆記本導覽(Notebook Guide)」?	系統自動生成的資料總覽面板,包含摘要、常見問題、學習指南、目錄、時間軸、簡介文件與音訊總覽。
23. 音訊總覽(Audio Overview / Podcast)的功能是什麼?	能將上傳的枯燥資料自動轉換成一男一女 AI 主持人的對話廣播,讓你可以用聽的方式掌握重點。
24. 音訊總覽支援中文語音嗎?	目前音訊總覽的主持人對談僅支援英文發音。即使上傳中文資料,產出的仍會是英文 Podcast。
25. 音訊總覽的內容可以控制嗎?	可以。點擊「自訂(Customize)」後,可以下提示詞要求主持人聚焦特定主題,或指定特定受眾。
26. 如果 AI 回答得很棒,怎麼保存下來?	點擊回答區塊右上角的「釘選到筆記(Pin to note)」按鈕,就能將這段精華永久保存在右側的記事面板中。
27. 如何消除 NotebookLM 的短暫記憶混亂?	因為對話具有記憶性,若發現 AI 混淆了先前提問,可以透過重新整理網頁來清除短期對話記憶。
28. 為什麼要在對話前進行「事實依賴性」評估?	因為這能確認任務是否需要 100% 依賴指定規章回答,不容許 AI 加入個人臆測;這類任務最適合交給 NotebookLM。
29. 為什麼 NotebookLM 會出現幻覺亂講話?	可能是上傳資料太少、品質太差,或只是把它當成單純的資料檢索工具來用,導致輸出品質不穩。
30. 怎麼下指令防堵 AI 產生幻覺?	可在提示詞結尾加上防護栓:「請僅根據上傳的來源回答。若找不到答案,請直接回答『資料中未提供相關資訊』,絕對不可自行推論。」
31. 什麼是「摘要型」提問?	測試 AI 抓取資料大意的問法,例如:「這批客戶意見整體在說什麼?」或「請幫我整理三個最重要的發現」。
32. 什麼是「查找型」提問?	測試文件是否包含特定細節的問法,例如:「文件裡有沒有提到某個規定、數字或結論?」
33. 什麼是「判讀型 / 決策型」提問?	賦予 AI 角色進入工作場景的問法,例如:「如果我是承辦人,先看這份資料的哪三點最有幫助?」
34. 給高階主管的報告(Executive Summary)該怎麼下提示詞?	可要求 AI 撰寫 300 字內摘要,必須包含最大亮點、隱藏風險、優先解決事項,並使用客觀商務口吻。
35. 如何處理上百則客訴回饋文字?	指示 AI 進行標籤化與分類,整理出 3 到 5 個主要類別標籤,並用表格呈現核心原因與具體引述客戶原話。
36. 什麼是行動方案發想(Actionable Insights)提示詞?	要求 AI 根據資料痛點,提出 3 個不需要花大錢、且一個月內可立即落實的 Quick Wins。
37. 如何用語氣轉換指令應對公關危機?	可採兩階段指令:先找出結論,再要求改寫為「安撫客戶的溫暖內部信」與「官網的精簡 FAQ 清單」兩種版本。
38. 讓 NotebookLM 出選擇題考卷的技巧是什麼?	提示詞可要求「20 題單選,從來源出題並附解答」,並明確規定排版結構,避免使用 Markdown 標籤,方便後續複製。
39. 如何把 AI 出的考卷快速變回 Google 表單?	要求 AI 以特定逗號分隔格式輸出,例如 Question、Type、Points、Correct Answer 等,再透過 Form Builder 外掛匯入。
40. 把試算表資料丟給 NotebookLM 分析前要先做什麼?	必須先清理髒資料,留下有意義的文字回饋,並砍掉無關欄位,讓資料乾淨聚焦後再轉成文件匯入。
41. 什麼是跨文件檢索(Cross-Document Retrieval)?	將多份相關文件同時匯入一個筆記本,詢問問題時 AI 會自動跨文件融合,找出完整解答。
42. 在履歷篩選上使用 NotebookLM 要注意什麼風險?	AI 容易過度美化求職者。為避免公平性問題,建議一次只分析一位求職者的履歷。
43. 選取來源特定段落提問有什麼好處?	這種方式不是靠 RAG 分段檢索,而是直接在超大上下文中理解該段落,因此回答品質通常更高、更精準。
44. 發現文件裡出現簡體字或中國用語怎麼辦?	可在提示詞中加入規則,例如「確保輸出為繁體中文(台灣),禁止使用流行語」,以規範輸出語言風格。
45. 為什麼用 NotebookLM 看表格會出錯?	NotebookLM 對 PDF 中複雜表格的理解能力有限。遇到重要報表,建議先把表格截圖 OCR 轉成文字,或用純文字重新排版。
46. 什麼是端到端除錯金字塔的底層問題?	發生在 Google 表單端,例如沒有設定必填或輸入驗證,導致後續收到亂碼或空白資料,造成自動化流程失敗。
47. 什麼是端到端除錯金字塔的中層問題?	發生在試算表與 GAS 之間,例如表單題目改名後,造成 GAS 程式中的欄位名稱對不上而報錯。
48. 什麼是端到端除錯金字塔的頂層問題?	發生在 NotebookLM 分析端,例如資料格式不支援、AI 產生幻覺,或提問太發散而導致回答無實質意義。
49. 遇到 GAS 自動化寄信失敗,第一步該查什麼?	進入 Apps Script 的「執行項目(Executions)」畫面查看紅色失敗紀錄,它會指出哪一行發生錯誤。
50. 為什麼要學這一整套 AI 雲端資料工作流?	不只是學單一工具,而是學會問對問題、把髒資料變可用,並把「收資料 → 整理 → 分析 → 通知」串起來,真正提升工作效率。
51. 「職場 AI 加速術」課程的核心目標是什麼?	幫助學員建立一套從「收資料 → 整理分析 → 產出報告 → 自動通知」的完整雲端自動化工作流,並結合 AI 工具提升決策與行政效率。
52. 課程第一週(W01)的主要學習內容是什麼?	建立 AI 雲端資料工作流程的整體概觀,了解一般聊天型 AI 與 NotebookLM 在事實依賴性上的差異,並完成知識庫首次匯入與提問實作。
53. 課程第二週(W02)的主要學習內容是什麼?	學習問卷與資料收集設計,操作 Google 表單的各種題型與邏輯跳題,並正確連動至 Google 試算表。
54. 課程第三週(W03)的主要學習內容是什麼?	學習 Google 試算表的資料清洗與圖表展示,包含常用函數、樞紐分析表與基礎視覺化圖表。
55. 課程第四週(W04)的主要學習內容是什麼?	學習 AI 輔助分析與報告撰寫,將試算表中的文字意見整理後匯入 NotebookLM,再透過 Prompt 產出摘要與主管報告。
56. 課程第五週(W05)的主要學習內容是什麼?	學習自動化通知與定期摘要,使用 GAS 寫出表單送出後自動寄信,以及定時寄送週報的流程。
57. 課程第六週(W06)的主要學習內容是什麼?	進行綜合專案實戰,將表單、試算表、NotebookLM 與 GAS 串起來,打造完整的自動化應用。
58. 為什麼課程一直強調「先整理資料,再交給 AI 分析」?	因為要避免垃圾進、垃圾出。如果資料本身髒亂或欄位不一致,AI 就容易誤判,只有乾淨聚焦的資料才能產生高價值洞察。
59. 課程中提到的端到端除錯金字塔,底層和中層分別代表什麼?	底層代表 Google 表單端,重點在必填與輸入驗證等防呆;中層代表試算表與 GAS 端,重點在欄位名稱同步與觸發器權限。
60. 學習這套 AI 雲端資料工作流,最終能為職涯帶來什麼價值?	單一工具隨時可能被淘汰,但學會問對問題、看懂數據,以及知道何處該自動化、何處該保留人工把關的方法論,不會過時。
61. 這門「職場 AI 加速術」課程的詳細資訊與報名網址在哪裡?	歡迎隨時查看最新開課資訊與課綱,請點擊下方按鈕前往查看:https://www.nutc.edu.tw/
在剛剛那份 Google 試算表上方選單,點選「擴充功能」→「Apps Script」,將專案命名為「LINE 課程 AI 助教」。
接著先設定密鑰,不要急著貼程式碼。進入 Apps Script 左側的「專案設定」,找到「指令碼屬性」,新增以下 4 個屬性:
| 屬性名稱 | 內容 |
|---|---|
LINE_CHANNEL_ACCESS_TOKEN | LINE Developers 裡產生的長效 Channel Access Token |
GEMINI_API_KEY | Google AI Studio 產生的 Gemini API Key |
SPREADSHEET_ID | Google 試算表網址 /d/ 到 /edit 中間那段 ID |
WEBHOOK_SECRET | 自己設定一段難猜的字串,例如 32 字以上隨機英數字 |

WEBHOOK_SECRET 不是取代 LINE 官方簽章驗證的完整做法,但在純 GAS Web App 很實用:稍後把它加在 Webhook URL 的 query string 裡,可以擋掉一部分亂掃公開網址的請求。

把原本編輯器內的程式碼清空後,直接貼上以下版本。這份程式除了支援文字與圖片問答,也能從 AI 回覆中抓出網址,自動轉成漂亮的 CTA 按鈕。
這版程式會從 Script Properties 讀取 LINE_CHANNEL_ACCESS_TOKEN、GEMINI_API_KEY、SPREADSHEET_ID 與 WEBHOOK_SECRET,所以不要再把真正的 API Key 貼進程式碼。
這裡的實作重點和我在Zeabur 使用 n8n 開發 LINE Bot那篇文章提到的概念很像:先讓 AI 回傳結構化 JSON,再由程式把內容轉成 Flex Message。差別在於這次不靠 n8n 節點,而是直接用 GAS 完成整個流程。
/**
* 職場 AI 加速術:課程專屬 LINE BOT 助教
* 功能:文字/圖片問答、5 則上下文記憶、Flex Message 輪播卡片回覆、聯外按鈕動態生成、進階心法建議
*/
// =========================================================================
// 1. 基本設定
// =========================================================================
const SCRIPT_PROPERTIES = PropertiesService.getScriptProperties();
const LINE_CHANNEL_ACCESS_TOKEN = SCRIPT_PROPERTIES.getProperty('LINE_CHANNEL_ACCESS_TOKEN');
const GEMINI_API_KEY = SCRIPT_PROPERTIES.getProperty('GEMINI_API_KEY');
const SPREADSHEET_ID = SCRIPT_PROPERTIES.getProperty('SPREADSHEET_ID');
const WEBHOOK_SECRET = SCRIPT_PROPERTIES.getProperty('WEBHOOK_SECRET');
const SHEET_NAME_HISTORY = '聊天紀錄';
const SHEET_NAME_QA = 'QA知識庫';
const GEMINI_MODEL = 'gemini-3.1-flash-lite-preview';
function assertRequiredConfig() {
const missingKeys = [];
if (!LINE_CHANNEL_ACCESS_TOKEN) missingKeys.push('LINE_CHANNEL_ACCESS_TOKEN');
if (!GEMINI_API_KEY) missingKeys.push('GEMINI_API_KEY');
if (!SPREADSHEET_ID) missingKeys.push('SPREADSHEET_ID');
if (missingKeys.length > 0) {
throw new Error(`缺少必要的指令碼屬性:${missingKeys.join(', ')}`);
}
}
function isValidWebhookRequest(e) {
if (!WEBHOOK_SECRET) {
return true;
}
return e && e.parameter && e.parameter.key === WEBHOOK_SECRET;
}
// =========================================================================
// 2. 主程式入口:接收 LINE 的 Webhook 事件
// =========================================================================
function doPost(e) {
try {
assertRequiredConfig();
if (!isValidWebhookRequest(e)) {
console.warn('Webhook secret 驗證失敗');
return ContentService.createTextOutput('Forbidden');
}
const eventData = JSON.parse(e.postData.contents);
const events = eventData.events;
if (!events || events.length === 0) {
return ContentService.createTextOutput('OK');
}
for (let i = 0; i < events.length; i++) {
const event = events[i];
const replyToken = event.replyToken;
const userId = event.source.userId;
if (event.type !== 'message') {
continue;
}
let userMessage = '';
let base64Image = null;
if (event.message.type === 'text') {
userMessage = event.message.text;
} else if (event.message.type === 'image') {
base64Image = getLineImageContent(event.message.id);
userMessage = '請分析這張圖片,並解答我的問題或提供課程相關建議。';
} else {
continue;
}
const history = getHistory(userId);
const aiResponse = callGeminiAPI(userMessage, base64Image, history);
history.push({ role: 'user', parts: [{ text: userMessage }] });
history.push({ role: 'model', parts: [{ text: JSON.stringify(aiResponse) }] });
saveHistory(userId, history);
saveLogToSheet(userId, userMessage, aiResponse);
replyWithFlexMessage(replyToken, aiResponse);
}
return ContentService.createTextOutput('OK');
} catch (error) {
console.error(error);
return ContentService.createTextOutput('Error');
}
}
// =========================================================================
// 3. LINE API 溝通相關函式
// =========================================================================
function getLineImageContent(messageId) {
const url = `https://api-data.line.me/v2/bot/message/${messageId}/content`;
const options = {
method: 'get',
headers: {
Authorization: `Bearer ${LINE_CHANNEL_ACCESS_TOKEN}`,
},
};
const response = UrlFetchApp.fetch(url, options);
const blob = response.getBlob();
return Utilities.base64Encode(blob.getBytes());
}
function replyWithFlexMessage(replyToken, aiData) {
const url = 'https://api.line.me/v2/bot/message/reply';
const bubbles = [];
const answerBubble = {
type: 'bubble',
header: {
type: 'box',
layout: 'vertical',
contents: [
{
type: 'text',
text: '👨🏫 助教解答',
weight: 'bold',
size: 'xl',
color: '#ffffff',
},
],
backgroundColor: '#2980b9',
},
body: {
type: 'box',
layout: 'vertical',
contents: [
{
type: 'text',
text: aiData.answer,
wrap: true,
size: 'md',
},
],
},
};
if (aiData.action_url && aiData.action_url.startsWith('http')) {
answerBubble.footer = {
type: 'box',
layout: 'vertical',
spacing: 'sm',
contents: [
{
type: 'button',
style: 'primary',
color: '#2980b9',
height: 'sm',
action: {
type: 'uri',
label: aiData.action_label || '🔗 點擊前往',
uri: aiData.action_url,
},
},
],
flex: 0,
};
}
bubbles.push(answerBubble);
if (aiData.tips && aiData.tips.length > 0) {
aiData.tips.forEach(function (tip, index) {
bubbles.push({
type: 'bubble',
header: {
type: 'box',
layout: 'vertical',
contents: [
{
type: 'text',
text: `💡 優化心法 ${index + 1}`,
weight: 'bold',
size: 'lg',
color: '#ffffff',
},
],
backgroundColor: '#e67e22',
},
body: {
type: 'box',
layout: 'vertical',
contents: [
{
type: 'text',
text: tip.title,
weight: 'bold',
size: 'md',
color: '#d35400',
wrap: true,
},
{
type: 'separator',
margin: 'md',
},
{
type: 'text',
text: tip.desc,
wrap: true,
size: 'sm',
margin: 'md',
},
],
},
});
});
}
const payload = {
replyToken: replyToken,
messages: [
{
type: 'flex',
altText: '助教回覆了您的問題!',
contents: {
type: 'carousel',
contents: bubbles,
},
},
],
};
const options = {
method: 'post',
headers: {
'Content-Type': 'application/json',
Authorization: `Bearer ${LINE_CHANNEL_ACCESS_TOKEN}`,
},
payload: JSON.stringify(payload),
};
UrlFetchApp.fetch(url, options);
}
// =========================================================================
// 4. Gemini AI 溝通相關函式
// =========================================================================
function callGeminiAPI(userMessage, base64Image, history) {
const url = `https://generativelanguage.googleapis.com/v1beta/models/${GEMINI_MODEL}:generateContent?key=${GEMINI_API_KEY}`;
const qaContext = getQAKnowledge();
const systemInstruction = `
你是「職場 AI 加速術:NotebookLM 與雲端工具應用」課程的專屬 AI 助教。
你的任務是解決學員關於 Google 表單、Google 試算表(公式、樞紐分析、圖表)、NotebookLM 與 GAS 自動化的問題。
如果使用者上傳了圖片(例如報錯截圖或資料截圖),請仔細觀察圖片內容找出錯誤或給予建議。
${qaContext}
【回覆格式嚴格限制】
你必須直接回傳一個純 JSON 格式的物件,不能包含 markdown 的 json 區塊標籤,格式如下:
{
"answer": "直接且親切地回答使用者的問題或報錯原因...",
"action_label": "按鈕文字(若解答中需要提供網址,請給簡短行動呼籲;若無網址請留空)",
"action_url": "若解答中需要提供網址連結請填入此處(需為 http 或 https 開頭;若無網址請留空)",
"tips": [
{
"title": "進階心法標題",
"desc": "如何做得更好的具體建議或觀念說明..."
}
]
}
`;
const currentMessageParts = [];
if (base64Image) {
currentMessageParts.push({
inlineData: {
mimeType: 'image/jpeg',
data: base64Image,
},
});
}
currentMessageParts.push({ text: userMessage });
const contents = history.concat([
{
role: 'user',
parts: currentMessageParts,
},
]);
const payload = {
systemInstruction: {
parts: [{ text: systemInstruction }],
},
contents: contents,
generationConfig: {
responseMimeType: 'application/json',
},
};
const options = {
method: 'post',
contentType: 'application/json',
payload: JSON.stringify(payload),
muteHttpExceptions: true,
};
const response = UrlFetchApp.fetch(url, options);
const json = JSON.parse(response.getContentText());
try {
const responseText = json.candidates[0].content.parts[0].text;
return JSON.parse(responseText);
} catch (e) {
return {
answer: '抱歉,助教剛剛有點當機,請再試一次或換個說法詢問喔!',
action_label: '',
action_url: '',
tips: [],
};
}
}
// =========================================================================
// 5. 對話紀錄(上下文)快取管理
// =========================================================================
function getHistory(userId) {
const cache = CacheService.getScriptCache();
const historyStr = cache.get(`history_${userId}`);
if (historyStr) {
return JSON.parse(historyStr);
}
return [];
}
function saveHistory(userId, newHistory) {
const cache = CacheService.getScriptCache();
if (newHistory.length > 10) {
newHistory = newHistory.slice(newHistory.length - 10);
}
cache.put(`history_${userId}`, JSON.stringify(newHistory), 1800);
}
// =========================================================================
// 6. Google 試算表整合函式
// =========================================================================
function getQAKnowledge() {
try {
const sheet = SpreadsheetApp.openById(SPREADSHEET_ID).getSheetByName(SHEET_NAME_QA);
if (!sheet) {
return '';
}
const data = sheet.getDataRange().getValues();
if (data.length <= 1) {
return '';
}
let qaString = '【以下為課程專屬 QA 知識庫,若學員詢問相關問題,請優先參考以下內容並整合進回覆:】\n';
for (let i = 1; i < data.length; i++) {
const question = data[i][0];
const answer = data[i][1];
if (question && answer) {
qaString += `Q: ${question}\nA: ${answer}\n\n`;
}
}
return qaString;
} catch (e) {
console.error('讀取 QA 知識庫失敗:', e);
return '';
}
}
function saveLogToSheet(userId, userMessage, aiResponse) {
try {
const sheet = SpreadsheetApp.openById(SPREADSHEET_ID).getSheetByName(SHEET_NAME_HISTORY);
if (!sheet) {
return;
}
const timestamp = new Date();
const aiAnswerText = aiResponse.answer || '無文字回應';
sheet.appendRow([timestamp, userId, userMessage, aiAnswerText]);
} catch (e) {
console.error('儲存紀錄至試算表失敗:', e);
}
}
點擊 GAS 編輯器右上角的「部署」→「新增部署作業」。
第一次部署時,Google 會要求你授權 Apps Script 存取相關服務。由於這支程式會用到 SpreadsheetApp,系統會另外提示試算表權限,照流程授權即可。
完成後你會拿到一組以 https://script.google.com/macros/s/.../exec 開頭的網址。為了搭配剛剛設定的 WEBHOOK_SECRET,請在網址後面加上 ?key=你的_WEBHOOK_SECRET,最後會像這樣:
https://script.google.com/macros/s/你的部署ID/exec?key=你的_WEBHOOK_SECRET

這就是等一下要貼回 LINE Developers 的 Webhook URL。這個做法的目標不是做到銀行等級的驗證,而是避免任何人只要猜到 GAS Web App 網址就能直接送假資料進來。若你要做更嚴謹的正式服務,建議改用 Cloud Run、Cloudflare Workers 或其他能讀取 HTTP Header 的後端,並驗證 LINE 的 X-Line-Signature。
如果你想比較不同部署方式,我之前也寫過在 Render 上快速部署 HackMD 與 LINE 的聊天機器人,以及用 GitHub Codespace 建立並部署 LINE Bot。這篇採用 GAS,是因為課程場景已經使用 Google 試算表,資料庫、程式與部署都放在同一個 Google 生態系裡,維護成本會更低。

進入你的 Messaging API 設定頁面後:
?key=... 的 Apps Script 網址這支範例程式會把學員的提問與 AI 回覆寫進 Google 試算表,這對教學分析很有幫助,但也代表你正在保存對話資料。實務上建議這樣處理:

圖:Webhook URL 加上 shared secret 只是第一層門禁;真正上線後,聊天紀錄的權限與保存期限也要一起管理。
學員LINE ID 改成匿名代號,或刪除舊資料。如果你的場景真的會處理個資或企業內部資料,就不要把這篇範例直接當正式系統上線;至少要再補上權限控管、資料保存政策、錯誤告警與 API 使用量監控。


你可以先從最簡單的問題開始測,例如直接傳:
請問課程的報名網址在哪裡?
如果設定正確,助教會回你一組 Flex Message 輪播卡片。第一張卡片會顯示主要解答,並自動產生「點擊前往」的網址按鈕;後面的卡片則會顯示進階心法或補充技巧。這樣的呈現方式不只資訊更清楚,對學員來說也更像一個真的有被設計過的服務。
接著你也可以試幾種更貼近實際教學現場的情境:
這套做法的關鍵,不只是把 LINE 和 AI 串起來,而是把「知識庫、上下文、結構化輸出、商務流程」四件事一起做好。
以前很多人做 LINE Bot,做到最後會卡在兩個問題:第一是 AI 很會講,但講錯也很敢講;第二是訊息送出去之後,完全沒有留下可分析的資料。這篇文章的做法,剛好就是針對這兩個問題下手。
你把課程資訊、FAQ、標準說法寫在 Google 試算表裡,AI 每次回覆前都先參考它,等於先幫助教建立了「說話邊界」。這個方向延續了我在客製化 AI 教學助手裡談過的角色設定概念,只是這次再往前多做了知識庫、圖片理解與對話紀錄。再配合 CacheService 的短期上下文記憶,以及 Flex Message 的結構化輸出,就能把原本散亂的問答體驗,變成更像真人助教的服務流程。


這次的升級,示範的是一種很務實的 AI 應用方式:不是追求讓模型什麼都會,而是把它放進一個你能控制、能維護、能分析的流程裡。
透過 GAS、Gemini、LINE Messaging API 與 Google 試算表,你可以用相對低門檻的方式做出一個專屬課程助教,還能持續擴充知識庫、優化回覆品質,甚至回頭分析學員真正卡住的問題。
如果你也想做一個「不只會回話,還能真正幫忙教學」的 LINE AI 助教,這套架構很值得你直接實作一次。
Java 陣列是 call by address?Python 是 call by reference?兩個常見誤解一次釐清

剛開始教初學者時,我很常看到同一種答案反覆出現:
這兩句話都很像對的,因為從執行結果看起來,真的很像「我把東西交進去,裡面改了,外面也跟著變」。但也正因為「看起來很像」,但又似乎看過相異的解釋,深怕錯誤的解釋會影響學習效果。
這篇我從錯誤認知出發,借助 AI 詢問釐清自己的觀念,最後希望能回到官方真正的說法。

不是 call by address,而是 pass by value。只是當你傳的是物件或陣列時,傳進去的那個「值」,是參考值的副本。
Python 官方也不把它叫做 call by reference。Python FAQ 的說法是 arguments are passed by assignment,而且明白寫到 there's no ... call-by-reference。
所以,如果要用一句最不容易誤導學生的話來說:
Java 一律是傳值;Python 不是 call by reference。

因為下面這種程式,真的很容易讓人誤會。
public class Main {
    public static void change(int[] arr) {
        arr[0] = 100;
    }

    public static void main(String[] args) {
        int[] nums = {1, 2, 3};
        change(nums);
        System.out.println(nums[0]);
    }
}
輸出:
100
def change(arr):
    arr[0] = 100

nums = [1, 2, 3]
change(nums)
print(nums[0])
輸出:
100
學生看到這裡,第一個反應通常都很合理:
「都改得到外面,那不就是 reference 嗎?」
這個推論很自然,但問題就出在這裡:「改得到同一個物件內容」不等於「呼叫端變數本身是被 reference 傳進去」。

最容易卡住的地方,是腦中會把變數想成「盒子裡直接裝著整個陣列」。
但比較接近實際的理解是:

可以先想成這樣:
nums ───► [1, 2, 3]
在 Java 裡,這種理解格外重要,因為官方規格直接寫到:arrays are objects。也就是說,陣列本身就是物件。
Java 官方原文: "In the Java programming language, arrays are objects..." — JLS Chapter 10

這是常看到的說法,也是在教學時對照文獻後想要釐清的根本觀念。Java 官方教學的英文原意很直接:
"Reference data type parameters, such as objects, are also passed into methods by value." — Oracle Java Tutorials
這句話很重要,原文比中文更能解釋,代表當你呼叫:
change(nums);
Java 不是把 nums 這個變數本人交進去,而是把 nums 裡面保存的那個參考值複製一份,交給方法參數 arr。
所以比較像這樣:
main 內                 change 內

nums ───► [1, 2, 3] ◄─── arr
因為 nums 和 arr 都指向同一個陣列,所以你在方法裡做:
arr[0] = 100;
改到的是同一個陣列內容,外面當然也會看到變化。
這也是為什麼學生會覺得「很像 reference」,但官方還是堅持它叫 by value:因為被複製的是參考值,不是外面那個變數本身。

我們直接看第二個例子。
public class Main {
    public static void reset(int[] arr) {
        arr = new int[]{9, 9, 9};
    }

    public static void main(String[] args) {
        int[] nums = {1, 2, 3};
        reset(nums);
        System.out.println(nums[0]);
    }
}
輸出:
1
如果 Java 真的是「外面的變數直接被交進方法裡」,那 arr = new int[]{9,9,9}; 之後,外面的 nums 理論上也應該一起改掉。
但它沒有。
原因就在於:
arr 拿到的只是 nums 的參考值副本arr 改去指向新陣列arrnums 還是原本那個陣列圖解會更清楚:
原本:
nums ───► [1, 2, 3] ◄─── arr

方法內重新指定後:
nums ───► [1, 2, 3]

arr  ───► [9, 9, 9]
也就是說,Java 陣列傳參數時真正發生的是:
這就是 Java 官方為什麼堅持它是 pass by value。
 這個
誤解也非常普遍,原來的我也無法很精確地釐清,尤其對於學過 C、C++ 之後再來看 Python,更容易直接套上 call by reference 這個詞。
但 Python 官方 FAQ 寫得更直接:
"Remember that arguments are passed by assignment in Python."
而且同一段後面還有一句更關鍵的:
"Since assignment just creates references to objects, there's no alias between an argument name in the caller and callee, and consequently no call-by-reference." — Python FAQ
意思是:
先看一個大家都很熟的例子:
def change(arr):
    arr[0] = 100

nums = [1, 2, 3]
change(nums)
print(nums[0])
輸出:
100
這時候可以想成:
nums ───► [1, 2, 3] ◄─── arr
因為 nums 和 arr 都指向同一個 list,所以改 arr[0] 時,當然也就改到了原本那個 list 內容。
但真正的關鍵,是再看另一個例子。
def reset(arr):
    arr = [9, 9, 9]

nums = [1, 2, 3]
reset(nums)
print(nums[0])
輸出:
1
這裡和 Java 幾乎是同樣的觀察:
arr = [9, 9, 9] 只是把函式裡的 arr 改成指向另一個新物件nums 完全沒有被重新綁定[1, 2, 3]圖解:
原本:
nums ───► [1, 2, 3] ◄─── arr

重新指定後:
nums ───► [1, 2, 3]

arr  ───► [9, 9, 9]
所以 Python 的問題不是「它很像 reference」,而是「它常常讓你誤以為參數和外面變數是同一個東西」。官方才會特別說:no call-by-reference。

不是語法,而是基於以下重要的核心區別:
透過與AI互動詢問,我發現可以透過上述問題釐清觀念:
arr[0] = 100;
arr[0] = 100
這叫改同一個物件的內容。因為兩邊都還指向同一個陣列 / list,所以外面看得到。
arr = new int[]{9, 9, 9};
arr = [9, 9, 9]
這叫讓參數自己改去指向新物件。這時候只會影響函式裡的參數,不會改到外面的變數綁定。
很多誤解,其實不是搞不懂 reference,而是把「改內容」和「改指向」混成同一件事。
在這個問題上,它們的表現結果很像,只是官方命名方式不同。
如果要將正確的意義教給學生,也許我建議這樣講,比較能貼近英文原意與實際程式行為:
Java:傳的是參考值的副本。 Python:函式參數只是新增一個指向同一物件的名字。

| 項目 | Java 陣列 | Python list |
|---|---|---|
| 常見的不精確說法 | call by address | call by reference |
| 官方較準確說法 | pass by value | passed by assignment |
| 傳進去的是什麼 | 參考值的副本 | 對同一物件的名稱綁定 |
| 可不可以改原本內容 | 可以 | 可以 |
| 重新指定新物件會不會影響外面 | 不會 | 不會 |
以上幾點都能從 Java 官方教學與 Python 官方 FAQ 對照得到。
很多人會說:
「可以改到外面的值,所以就是 reference。」
這句話有很大的問題是把結果當成機制,你看到的結果是「內容被改到了」,但真正的機制可能只是「兩邊都剛好指向同一個可變物件」。
這兩件事長得很像,但不是同一件事。Java 與 Python 官方文件,其實都在提醒你這個差別。

Java 一律是 pass by value。陣列或物件傳入方法時,傳的是參考值的副本。
Python arguments are passed by assignment。Python 官方 FAQ 也明確指出沒有 call-by-reference。
再補一句白話版:
兩者都能改內容,但都不能直接改掉外面變數本身的指向。
把這句記起來,這個觀念就不太會再混掉了。
你有沒有遇過這種狀況:寫 Python 程式時,明明在自己電腦能跑,但換到同學的電腦就出錯?或者安裝了一個新套件後,之前的程式竟然跑不動了?
這就像你在房間裡亂丟衣服,最後找不到想穿的衣服一樣!今天要介紹一個超厲害的工具 uv,它就像是幫你整理房間的魔法管家,讓每個 Python 專案都有自己整齊的「小房間」。
想像一下,你的電腦就像是一個大宿舍,每個 Python 專案就像是一個學生。如果所有學生都住在同一間房間,就會很亂:
uv 就像是宿舍管理員,它會給每個專案分配一個獨立的房間(虛擬環境),讓大家各自安心使用需要的工具。
uv 是一個用 Rust 語言製作的超快工具,它可以幫你:
最重要的是,uv 超級快! 官方說它比傳統方式快了 10 到 100 倍。就像從走路換成坐高鐵一樣!
| 功能 | 傳統方法 (venv + pip) | uv |
|---|---|---|
| 速度 | 慢,重複下載套件 | 非常快,有快取功能 |
| 鎖檔 | 要另外裝 pip-tools 或 poetry | 已經內建 |
| 版本管理 | 要另外裝 pyenv 工具 | 自動下載指定版本的 Python |
| 工具執行 | 要另外裝 pipx | 直接使用一次性工具執行 |
| 易用性 | 要記很多不同工具 | 一個工具搞定全部功能 |
🔧 真實痛點分享:我記得剛學 Python 的時候,為了做學校作業安裝了 numpy 1.19,結果同時要做另一個專案時,發現需要 numpy 1.21 才能跑。我天真地直接升級,結果之前的作業程式全部掛掉,當時真的快哭了!那時候我還不知道虛擬環境這個救星。
👥 團隊合作的慘痛經驗:和同學一起做專題時,我的電腦用 requests 2.31,他的電腦是 2.25,結果我們的 API 呼叫程式在我這邊跑得好好的,到他那邊就一直報錯。我們找 bug 找了整整一個下午,最後才發現是版本不同惹的禍!
你可以想像一下,如果你和室友共用一個書桌:
虛擬環境就像給每個人一個專屬的文具盒,這樣:
requirements.txt 記錄需要哪些套件(就像列購物清單).venv/ 加到 .gitignore(不要把整個房間都上傳到 GitHub)Q:虛擬環境會佔用很多硬碟空間嗎? A:每個虛擬環境大約 10~30MB,就像一個小遊戲的大小,完全不用擔心!
Q:虛擬環境會不會把我的 Python 弄壞? A:絕對不會!虛擬環境就像在沙盒裡玩沙,只在自己的小天地裡運作,對外面的世界完全沒影響。
Q:忘記啟動虛擬環境怎麼辦? A:沒關係!只要重新啟動就好,就像忘記帶文具盒去教室,回去拿就好了。
✅ 小結:虛擬環境就像專屬工具箱 使用虛擬環境就像給每個專案準備一個專屬的工具箱,裡面放著這個專案需要的所有工具。這樣不同專案就不會互相干擾,也能確保和同學合作時大家用的工具都一樣。
🎯 親身經歷分享:剛開始學 Python 時,光是搞懂 venv、pip、requirements.txt 這些東西就花了我好久時間。每次要開新專案都要敲一堆指令,有時候還會忘記步驟。自從用了 uv 之後,真的變得超簡單,一個指令就搞定!
以下步驟適合 Windows、macOS 和 Linux 使用者:
Windows 使用者:
# 先安裝 pipx(如果還沒有的話)
pip install pipx

# 用 pipx 安裝 uv
pipx install uv
macOS 與 Linux 使用者:
# 官方推薦的安裝方式
curl -LsSf https://astral.sh/uv/install.sh | sh
💡 小提醒:就像下載 Line 或 Instagram 一樣,只要下載一次就可以一直用囉!
# 建立一個新的虛擬環境(就像蓋一間新房子)
uv venv

# 想要指定 Python 版本嗎?(就像選房間要幾坪大)
uv venv --python 3.12
Windows 使用者:
.\.venv\Scripts\activate
macOS 與 Linux 使用者:
source .venv/bin/activate
🎉 成功指標:看到終端機前面出現
(.venv)就表示你已經進入虛擬環境了!就像看到房門上貼著你的名字一樣。
# 安裝單一套件(超快!)
uv pip install pandas

# 安裝多個套件
uv pip install pandas requests matplotlib

# 從檔案安裝所有套件(就像照購物清單買東西)
uv pip install -r requirements.txt
⚡ 速度體驗分享:以前用 pip 安裝 pandas 要等 30 秒,用 uv 只要 3 秒!就像從撥接網路升級到光纖一樣爽快!
# 建立套件清單(就像列出房間裡有什麼家具)
uv pip freeze > requirements.txt

# 建立更精確的鎖檔(確保每次都用相同版本)
uv pip compile requirements.in -o requirements.lock

# 依照鎖檔安裝(確保環境完全一樣)
uv pip sync requirements.lock
# 不用安裝就能使用工具(就像借朋友的計算機)
uv tool run black .  # 格式化程式碼
uv tool run pytest  # 執行測試
🎯 實用技巧:這個功能超讚!以前想用 black 格式化程式碼,還要先安裝,現在直接用就好了!
雖然 Colab 無法直接使用虛擬環境(因為它本身就是個線上環境),但可以善用 uv 的快取與加速特性:
# 在 Colab 裡這樣用
!pip install uv
!uv pip install pandas numpy matplotlib
💡 小技巧:建議搭配
%%capture抑制輸出,並於開頭一併執行,減少重複套件安裝時間。就像把購物清單一次買齊,不用每次都跑商店!
這是學生和開發者最常用的組合:
開啟 VS Code Terminal:
uv venv
.\.venv\Scripts\activate
uv pip install -r requirements.txt
在左下角 Python 解譯器切換到 .venv\Scripts\python.exe
將 uv 加入 settings.json 內的 python.defaultInterpreterPath 以利預設載入
🎯 實用心得:這樣設定後,每次打開專案都會自動使用正確的 Python 環境,就像房間會自動切換到你需要的照明模式一樣方便!
🔄 常見狀況:如果你已經習慣用 venv,沒關係!uv 很聰明,它可以跟你現有的虛擬環境和平共處。就像換了新的文具盒,舊的鉛筆還是可以用一樣!
如果你已經有 venv 的環境,完全不用重新開始:
# 在現有的虛擬環境裡,直接用 uv 安裝新套件
uv pip install 新套件名稱

# 用 uv 更新你的 requirements.txt
uv pip freeze > requirements.txt
💡 漸進式轉換小技巧:不用一次全部改掉,可以慢慢從新專案開始用 uv,舊專案照舊使用。就像換手機不用把所有照片都刪掉一樣!
雖然 uv 很棒,但有些情況還是要用傳統工具:
你的老師或主管堅持要用 Poetry(就像學校規定要穿制服一樣,沒辦法)
公司專案已經用 Conda 管理科學運算套件(就像全班都在用某個 App,你也要跟著用)
你需要一些特殊的 pip 參數(建議先確認 uv 是否支援)
🤷♂️ 實際建議:除了上述情況,大部分時候用 uv 都會讓你的開發更輕鬆!
如果想要移除 uv,可執行以下步驟:
uv cache clean
rm -r "$(uv python dir)"
rm -r "$(uv tool dir)"
rm ~/.local/bin/uv ~/.local/bin/uvx
以下透過實際範例比較,說明 uv 為什麼更受資深開發者喜愛:
以下透過實際範例比較,說明 uv 為什麼更受資深開發者喜愛:
# 建立虛擬環境
python -m venv .venv
source .venv/bin/activate

# 安裝套件
pip install -r requirements.txt

# 建立鎖檔
pip install pip-tools
pip-compile requirements.in
pip-sync requirements.txt
# 建立虛擬環境(若沒安裝過指定版本會自動處理)
uv venv --python 3.11

# 安裝套件
uv pip install -r requirements.txt

# 鎖檔與同步
uv pip compile requirements.in -o requirements.lock
uv pip sync -r requirements.lock
# 快速執行一次性工具,不汙染環境
uv tool run black .

# 移除全部快取與工具
uv cache clean
節省時間:省略繁瑣安裝流程,一鍵完成
減少工具切換:整合 venv、pip、pip-tools、pyenv、pipx
更穩定:官方支援、鎖檔清楚、快取合理
適合團隊:易於寫入 CI/CD,也適合教新手快速入門
根據官方說明與實務觀察,資深開發者選擇 uv 通常有以下幾個原因:
速度就是生產力:uv 利用 Rust 高效處理封裝、快取與安裝,極大減少套件安裝與環境建立時間。
整合工具多合一:uv 同時整合 venv、pip、pip-tools、pipx、pyenv 的功能,一套工具即可搞定開發日常。
強大的可重現性:內建 compile 與 sync 機制,能保證部署時環境一致、版本鎖定穩定。
自動管理 Python 版本:不必額外裝 pyenv,uv 可直接下載並使用特定版本的 Python,方便管理多版本開發需求。
適合 CI/CD 與 Docker:uv 是單一可執行檔,非常容易整合到自動化流程,避免繁瑣相依設定。
這些優點讓資深開發者能更快速部署、更輕鬆維護專案環境。
uv 可以幫你自動下載與管理所需的 Python 版本,無需另外安裝 pyenv:
# 安裝指定版本的 Python(若尚未存在)
uv python install 3.11

# 建立虛擬環境,並自動使用該版本
uv venv --python 3.11
透過這方式,開發者在不同專案間可以快速切換對應版本,避免「系統版本不同」導致出錯。
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3

      - name: 安裝 uv
        run: curl -LsSf https://astral.sh/uv/install.sh | sh

      - name: 安裝相依套件
        run: uv pip install -r requirements.txt

      - name: 執行測試
        run: uv run pytest
FROM python:3.11-slim

# 安裝 uv
RUN curl -LsSf https://astral.sh/uv/install.sh | sh

# 設定工作資料夾
WORKDIR /app
COPY . .

# 安裝套件
RUN uv pip install -r requirements.txt

CMD ["uv", "run", "python", "main.py"]
這讓部署流程更加簡潔、快速,特別適合雲端平台或自動測試環境。
🔍 我自己的使用心得:以前我會忘記啟動虛擬環境,或裝在錯的地方,導致電腦裡的套件亂七八糟。自從開始用 uv 後,流程變得簡單不易出錯,尤其在教學生或帶新手時更順利。
uv 速度快又簡單,是 Python 開發的新好朋友。趕快試試看吧!
更多資訊:uv 官方 GitHub。

這篇部落格將分享我在 Zeabur 使用 n8n 打造 LINE 聊天機器人的經驗,作為台中 AI 小聚假日場的第一位分享者,很榮幸能拋磚引玉與大家討論 Low Code 工具的實戰心得。
Zeabur 作為一個部署平台,擁有低門檻且豐富的樣板資源,整個部署流程可以用「絲滑」來形容,非常適合新手快速上手。但當實際開始串接 n8n 後,我發現情況可能稍有不同。

Zeabur 對於初學者來說非常友善,不論是部署速度還是樣板的多樣性,都能顯著降低技術門檻,讓沒有基礎的使用者也能快速啟動專案。

n8n 作為 Low Code 工具,雖然降低了不少開發門檻,但若你原本就習慣程式設計,反而可能需要額外時間熟悉各種節點操作與邏輯,這點可能會有些挫折。不過,對於有 API 串接經驗的人來說,n8n 仍然是個相對容易上手的強大工具。
Low Code 工具可以透過圖形控制拖拉等方式串接工作流程,使用者無須複雜的程式碼即可像積木般串接各個節點,達到方便彈性的優勢。
尤其推薦 5x 紅寶石 n8n 範本(搜尋 5x 即可找到),內建的登入介面能省下不少初始設置時間。這種內建登入系統能讓新手更快地跳過繁瑣的設定步驟,專注於功能實現。

在實際串接 LINE Bot 的過程中,我一開始直接使用 Webhook 節點回傳 Flex Message,但很快遇到了卡片數量彈性不足的問題。後來透過 AI 模型產生結構化 JSON,再透過 Function 節點處理,成功解決了動態調整訊息卡片數量的限制。
 GitHub - willismax/n8n-templates: 自己設定可以分享的n8n模板
透過這種結構化的方式,Flex Message 不再受限於固定格式,訊息卡片可以依據需求自由增減,更能滿足用戶互動多元化的需求。

為了進一步增強 AI 的效能,我也嘗試在 n8n 中建構了增強生成檢索(RAG)系統,並使用 Supabase 儲存文字與向量混合資料。

Supabase 的預設資料庫結構十分便捷,不過成本稍高,特別要注意 Kong 元件預設記憶體高達 700MB,經過優化可以降到 100MB 左右。
此外,Supabase 雖然功能強大,但成本效益需要特別留意,尤其在專案初期若資源有限,更需謹慎評估使用方式與頻率。

提醒大家一點: 建議不要將 Supabase 與 n8n 部署於同一個 Zeabur 專案內,因為底層都是 PostgreSQL 資料庫,可能會發生意想不到的衝突,創辦人戲稱為「薛丁格的資料庫」。
對於沒有程式基礎的使用者,建議先熟悉基本 API 串接技巧,有助於加速 n8n 的使用與應用。
透過 AI 模型輔助設計動態訊息結構,能有效解決 n8n 節點固定格式的問題。
持續監控與優化資源使用狀況,特別是 Supabase 等耗資源服務,才能更有效地控制專案成本。
以自己的經驗而言,Zeabur 與 n8n 的結合確實能為自動化流程提供便捷快速的解決方案,但實務操作中還是需要特別留意技術細節及資源管理,才能避免不必要的問題。最終,親自動手實踐才是掌握這些工具最好的方式。
希望今天的分享能給大家帶來一些啟發,也感謝 AI 小聚能給予我這個破圈的機會,期待未來更多的交流與學習!

Whisper 是一個高效能的聲音轉文字工具,由 Const-me 開發,基於 OpenAI 的 Whisper 自動語音識別(ASR)模型。這個工具主要是針對 Windows 平台開發,提供了一個高效且易於使用的介面來處理語音識別任務,重點是可以離線使用、速度快,專案網址為 https://github.com/Const-me/Whisper ,以下介紹如何安裝與使用。

下載和安裝:從 GitHub 存儲庫的“Releases”部分下載 WhisperDesktop.zip,解壓縮,並運行 WhisperDesktop.exe。


選擇模型:解壓縮啟動主程式(一個小花圖案),系統會提示您下載一個模型。建議下載 ggml-medium.bin(大小為1.42GB),因為這是作者最常用於測試的模型。


轉寫音頻文件:接下來的介面允許您選擇要轉寫的音頻文件。

 中文可能是繁體或簡體。WebVTT subtitles檔案可以上傳至Youtube影片字幕(有時間軸),視需要選用。
即時轉譯:此外,還有一個介面可以捕獲並轉寫或翻譯來自麥克風的即時音訊。
這個開源專案速度快、離線可用,而且對於隱私資料而言相對安全,可以幫助完成會議紀錄等任務,即便有錯誤也瑕不掩瑜,分享給有需要的各位。

在這篇文章中,我們將探討如何使用 GitHub Codespace 快速有效地建立和部署 LINE Bot。GitHub Codespace 提供了一個雲端開發環境,使得開發人員可以在任何地方進行開發和部署。這種方式的好處是不需要本地環境配置,且環境變數的設置增加了項目的安全性。
首先,你需要在 GitHub 上啟用 Codespace 並克隆你的專案。

在 Codespace 中設置你的 LINE Bot 的環境變數:
創建一個 .env 檔案。
加入以下環境變數:
LINE_CHANNEL_SECRET=你的channel_secret
LINE_CHANNEL_ACCESS_TOKEN=你的access_token
在這個示範專案,可以將MediaSystem-Python-Course\06.Line-bot-fly-flask\的config-templete.py另存為config.py,也就是環境變數儲存在config.py的檔案裡,這是一個簡易用法不建議正式使用,使用環境變數對機密資訊才有較佳的保護。
在 Codespace 的終端機運行以下命令安裝所需依賴:
pip install -r requirements.txt
使用 GitHub Copilot 來協助編寫和優化程式碼。例如,以下是一個簡單的 Flask 應用來回應 LINE Bot 的訊息:
from flask import Flask, request, abort
from linebot import LineBotApi, WebhookHandler
from linebot.exceptions import InvalidSignatureError
from linebot.models import MessageEvent, TextMessage, TextSendMessage

app = Flask(__name__)

line_bot_api = LineBotApi('YOUR_CHANNEL_ACCESS_TOKEN')
handler = WebhookHandler('YOUR_CHANNEL_SECRET')

@app.route("/callback", methods=['POST'])
def callback():
    signature = request.headers['X-Line-Signature']
    body = request.get_data(as_text=True)
    try:
        handler.handle(body, signature)
    except InvalidSignatureError:
        abort(400)
    return 'OK'

@handler.add(MessageEvent, message=TextMessage)
def handle_message(event):
    line_bot_api.reply_message(
        event.reply_token, TextSendMessage(text=event.message.text))

if __name__ == "__main__":
    app.run()`
啟動你的 Flask 應用並進行測試。你不需要使用 ngrok 來建立 TLS 認證。
使用 GitHub Codespace 來建立和部署 LINE Bot 是一個高效且安全的方法。這種方式不僅節省了設置本地開發環境的時間,還提供了一個穩定和安全的開發平台。希望這篇文章能夠幫助你順利完成 LINE Bot 的開發和部署。

老師們現在不僅對教學充滿熱情,也愈來愈善於運用科技工具,如LINE官方帳號,來與學生和家長保持緊密的溝通。這些努力無疑是朝著以下兩大目標邁進:
這個專案的核心目的是要讓老師們能在已有的LINE官方帳號上,快速加入一個AI助教—使用ChatGPT技術。這樣一來,AI助教能夠第一時間回應學生的問題,如果遇到AI不能解決的問題,它還會建議學生直接聯繫老師。這讓老師有更多的時間和空間來專注於其他重要的教學任務。
這個專案極力降低相關的技術門檻。實際上,在幾乎不需要寫任何程式碼的情況下,老師就能設置起這個AI助教服務。你只需完成以下幾個簡單的步驟:
完成以上步驟後,你就能讓ChatGPT開始擔任你的AI助教,預先回答學生的問題。
👉 歡迎各位老師運用,打造更智慧、更高效、教學相長的教學環境!
在你開始使用這個專案之前,有一些基礎的技術和費用信息你需要知道。
Vercel
OpenAI API

LINE 主動訊息


提醒您: 所有的費用和限制可能會隨著各個服務供應商的政策改變而變動,建議定期查看官方網站以獲取最新資訊。
這份指南將引領您從LINE 官方帳號開始,不同於開發者通常從 LINE Developers 開始。不過,不管從哪裡出發,最終目標相同:建立一個集成 ChatGPT 的 LINE 官方帳號。
首先,我們需要建立一個基本的、無AI功能的 LINE 官方帳號。學生們可以即刻加入這個帳號。這個帳號初期僅支持手動聊天,AI 功能將在後續逐步加入。
填寫必要資訊:這些資訊也會是學生看到的名稱。 
選擇「稍後認證官方帳號」:這個認證過程不會影響本專案。 
(選擇性)建立圖文選單:利用圖文選單可提供班級公告、相片集等。

啟用 Webhook 🔗


Channel Secret 🔒
Channel Access Token 🔑


OPENAI_API_KEY、LINE_CHANNEL_ACCESS_TOKEN及LINE_CHANNEL_SECRET,在這裡的環境變數能受到較佳的保護,至少比放在程式碼裡安全許多。
如果遇到Python安裝版本問題,依據官方文件,Vercel預設的Node.js版本為20.x,不支援Python,請在專案的設定>一般的選項裡,將Node.js改選為18.x版本。

修改後請選擇部署,或到專案的佈署歷程中選擇再次部署,就會改用Node.js 18.x版再跑一次。

恭喜您,現在您已經成功建立了自己的 AI 助教!現在可以透過 LINE 官方帳號進行測試。
若要讓AI助手更符合你的需求和風格,OpenAI API提供了一個彈性的方式讓你自行設定AI的角色。具體來說,你只需要在對話設定中添加 messages: [{ role: "system", content: "你的AI助手人設" }] 即可。
進行這項設定只需前往api/prompt.py並在AI_GUIDELINES後修改提示文字即可。不過,因為Vercel的免費版有10秒的運行時限制,過長的提示可能會導致Time Out,因此建議不要設置過於複雜的指引。
本專案經過精心測試後,已經內建一組最佳實踐的AI_GUIDELINES,但你也可以隨心所欲地進行調整:
AI_GUIDELINES = '你是一個AI助教,專門使用蘇格拉底教學法來回答學生的問題,如果有需要,會建議學生與老師進一步確認。'
修改方式也非常簡單,只需登入你的GitHub帳號,找到該專案的api/prompt.py文件,點擊右側的鋼筆圖示✏️即可進行線上編輯。 
完成後,選擇“Commit Changes”並填入適當的描述。 


同學A 老師我想要問BMI的python程式怎麼寫
----
AI助教  嗨!關於BMI的Python程式,我可以幫你一起思考。首先,你知道BMI是什麼嗎?
----
同學A BMI=體重/身高平方
----
AI助教  沒錯!BMI是體重除以身高的平方。那麼,你想要寫一個計算BMI的Python程式對吧?你已經有身高和體重的數值了嗎?
----
同學A 70/(1.73**2)
----
AI助教  沒錯!你可以使用這個公式來計算BMI。現在我們可以開始寫一個Python程式來計算BMI。你想要將身高和體重作為變數輸入嗎?
----
同學A 想
----
AI助教  好的!我們可以寫一個簡單的Python函數來計算BMI。以下是一個範例程式碼:

    ```python
    def calculate_bmi(weight, height):
    bmi = weight / (height ** 2)
    return bmi

    weight = float(input("請輸入您的體重(公斤):"))
    height = float(input("請輸入您的身高(公尺):"))

    bmi = calculate_bmi(weight, height)
    print("您的BMI為:", bmi)
    ```

這個程式會要求使用者輸入體重和身高,然後使用`calculate_bmi`函數計算BMI並輸出結果。請注意,身高的單位應該是公尺,體重的單位應該是公斤。
----
同學A 請幫我也寫出測試碼,之後會用pytest測試
----
AI助教  當然!我們可以寫一些測試碼來驗證我們的BMI計算函數是否正確。以下是一個範例的測試碼:

    ```python
    import pytest

    def calculate_bmi(weight, height):
    bmi = weight / (height ** 2)
    return bmi

    def test_calculate_bmi():
    assert calculate_bmi(70, 1.73) == pytest.approx(23.39, 0.01)
    assert calculate_bmi(80, 1.65) == pytest.approx(29.38, 0.01)
    assert calculate_bmi(60, 1.80) == pytest.approx(18.52, 0.01)

    if __name__ == "__main__":
    pytest.main()
    ```

這個測試碼使用了pytest套件來執行測試。我們定義了一個`test_calculate_bmi`函數,其中包含了幾個斷言語句,用來驗證`calculate_bmi`函數的輸出是否符合預期。每個斷言語句都使用了`pytest.approx`函數來比較浮點數的近似值,並指定了一個容忍誤差範圍。

你可以將這個測試碼保存為一個.py檔案,然後使用pytest運行測試。如果所有的測試通過,則表示你的BMI計算函數正確無誤。
----
同學A 謝謝老師,我的超人
----
AI助教  不客氣!如果你有任何其他問題,隨時都可以問我。祝你一切順利!


這個專案不僅具有高度的實用性,也很有教育意義。它不只是一個問答工具,更是一個能夠協助教學和學習的平台。
🐍 Python 是一種非常流行和強大的程式語言,它有許多優秀的套件可以幫助我們完成各種任務,例如資料分析、機器學習、網頁開發等。然而,如果我們同時在不同的專案中使用 Python,我們可能會遇到一些問題,例如:
為了解決這些問題,我們可以使用虛擬環境管理工具來創建和管理不同的 Python 環境。虛擬環境是一個隔離的 Python 環境,它可以讓我們在不同的專案中使用不同的 Python 版本和套件,而不會互相干擾。這樣,我們就可以更方便和安全地開發和部署我們的 Python 專案。
目前,有許多虛擬環境管理工具可以選擇,例如 virtualenv, conda, pyenv 等。在這篇文章中,我將重點介紹 pipenv 和 venv 這兩種工具,並且比較它們的優缺點。
pip 和 virtualenv 的功能,並且改進了它們的一些缺陷 。Pipfile 和 Pipfile.lock 來記錄套件的資訊,而不是使用 requirements.txt。
Pipfile 和 Pipfile.lock,不需要手動維護 。.env 自動載入不同環境變數。pipenv install 如同 pip installpipenv uninstallpipenv shell 如同 source venv/bin/activate 進入虛擬環。pipenv run 可以執行虛擬環境內容python -m venv {虛擬機命名} 來創建虛擬環境,然後使用 source venv/bin/activate 來啟動虛擬環境(Windows 以 venv/Scripts/activate 進入)。pip 和 requirements.txt 來管理套件,因為venv跟pip是兩回事,這可能會造成版本衝突和相依性問題。以下用表格比較 pipenv 和 venv 的差異,我用表格的方式來比較它們的特點:
| 特點 | pipenv | venv |
|---|---|---|
| Python 官方推薦 | 是 | 曾經是 |
| 集成 pip 和 virtualenv | 是 | 否 |
| 使用 Pipfile 和 Pipfile.lock | 是 | 否 |
| 自動產生和更新 Pipfile 和 Pipfile.lock | 是 | 否 |
| 包含套件的哈希值 | 是 | 否 |
| 區分開發和生產環境的套件 | 是 | 否 |
| 使用並行同步安裝套件 | 是 | 否 |
| 自動載入不同環境變數 | 是 | 否 |
| 指令簡單和直觀 | 是 | 否 |
從表格中,我們可以看出 pipenv 是一個更先進和完善的虛擬環境管理工具,它可以讓我們更方便和安全地開發 Python 專案。如果你想了解更多關於 pipenv 的資訊,但在基礎Python教學時,我更傾向以venv為主,因為你看到的網路專案大多還是venv + pip install -r requirements.txt 來示範的。可以參考以下的連結:
感謝你閱讀這篇文章,如果你有任何問題或建議,歡迎在下方留言。Enjoy Python。再見!
如果你對如何將 LINE 聊天機器人與 HackMD 結合有興趣,這篇文章正是你需要的。這次,我們將使用 Render 這個雲端平台來部署我們的應用。
Fork 專案:首先,請到這個 GitHub Repo 進行 fork,這樣你就有了一個屬於自己的副本。

登入 Render:前往 Render 的網站 並用 GitHub 帳號登入。

選擇 Web 服務:在 Render 的 dashboard,選擇 "Web Service"。

基本設定:填入應用的名稱和其他基本資訊。在這裡,我們選擇免費的方案。如果你的主程式檔名不是 app.py,記得修改 gunicorn 的指令。


設定環境變數:在 .env 檔案中填入所有需要的環境變數。

等待部署完成:設定完成後,Render 會自動進行部署。

訪問 OpenAI API 官網。
生成一個一次性的 API 金鑰。注意:一旦關閉視窗,這個金鑰將不再顯示。


你可以使用以下程式碼來讀取環境變數。
import os
api_key = os.environ.get('KEY')`
最後,回到 LINE Channel 設定中加入 webhook。

這樣你就完成了整個部署過程!如果你有任何問題或建議,歡迎在下方留言。祝學習愉快!
對於剛接觸人工智慧的學生來說,建立自己的聊天機器人可能聽起來有點遙不可及。不過,現在有越來越多的工具讓這個過程變得簡單。本篇文章會介紹如何使用 LM Studio 快速在筆電上實現大型語言模型(LLM)。
在開始之前,讓我們先簡單了解一下什麼是大型語言模型。簡單來說,它是一種能夠理解和生成人類語言的人工智慧模型。目前有很多開源的大型語言模型,像是 Meta 的 LLaMa 系列和 Hugging Face(簡稱 HF)的各種模型。
首先,請至 LM Studio 官網 下載適用於 Windows 或 Mac 的桌面應用程式。

安裝完畢後,打開 LM Studio。在首頁,你會看到最新或最熱門的模型資訊。使用搜尋框可以找到你需要的模型。例如,我搜尋 "Taiwan",找到了一個名為 audreyt/Taiwan-LLaMa-v1.0-GGUF 的模型。

備註: 模型資訊通常會包含在 HF 的模型卡(Model Card)和相關的論文連結。
選擇一個適合你硬體配置的模型進行下載。如果你的筆電不是高性能的,建議選擇小型的模型。

下載完成後,在左側選擇聊天頁籤。選擇你剛才下載的模型,等待模型加載完成後,就可以開始與聊天機器人對話了。

建立自己的聊天機器人是一個不斷演進的過程。儘管 LM Studio 提供了一個相當方便的平台,但要達到商業應用水平,還需要進一步的微調和量化調教。如果你想要更進一步,可以考慮使用 OpenAI、Azure、Google 或 AWS 等平台的 API 進行模型的微調。
希望這篇文章能幫助你更輕鬆地入手聊天機器人的建立,祝你在人工智慧的旅程中一切順利!
如果有任何問題或需要進一步的說明,歡迎留言。
在過去,我預期會遇到以下幾種情況:
然而,升級至 Selenium 4.x 後,我發現了一些令人驚喜的改變。
在 Selenium 4.x 版本之前,安裝 Selenium 是一件相對繁瑣的事情。你需要:
pip install 安裝 Selenium 主要套件。
pip install selenium
pip install webdriver_manager直接安裝好對應的測試瀏覽器,不用找對應的瀏覽器與版本,但需要引入webdriver_manager套件。
pip install webdriver_manager
from selenium import webdriver
from webdriver_manager.chrome import ChromeDriverManager

options = webdriver.ChromeOptions()
# options.add_argument('--headless')

wd = webdriver.Chrome(ChromeDriverManager().install(), options=options)
wd.get("https://www.google.com")
wd.save_screenshot("google_homepage.png")
wd.quit()
現在,在 Selenium 4.x 版本,你只需執行一個指令即可:
pip install selenium
這個改變意味著,你不再需要手動去管理 WebDriver,Selenium 會為你處理一切。
在舊版中,初始化 Chrome WebDriver 的代碼通常會看起來像這樣:
from selenium import webdriver

options = webdriver.ChromeOptions()
options.add_argument('--headless')

wd = webdriver.Chrome('path/to/chromedriver', chrome_options=options)
在新版中,由於 WebDriver 已經被整合,你可以簡單地這樣做:
from selenium import webdriver

options = webdriver.ChromeOptions()
options.add_argument('--headless')

wd = webdriver.Chrome(options=options)
如你所見,新版省去了指定 chromedriver 路徑的需求,使得代碼更為簡潔,最後分享一個這學期調整的selenium範例:
from selenium import webdriver
from selenium.webdriver import Chrome
from selenium.webdriver.chrome.options import Options
from bs4 import BeautifulSoup


def make_webdriver() -> Chrome:
  options = create_options()
  driver = Chrome(options=options) #簡化參數
  return driver


def create_options() -> Options:
  options = Options()
  options.add_argument("--headless")
  options.add_argument('--no-sandbox')
  options.add_argument('--disable-dev-shm-usage')
  options.add_argument("--start-maximized")
  return options


def get_ptt_board_list(board) -> list:
  url = f"https://www.ptt.cc/bbs/{board}/index.html"
  wd = make_webdriver()
  wd.get(url=url)
  soup = BeautifulSoup(wd.page_source,"html.parser")
  links = soup.select('div.title > a')
  res = [{
      'title': link.get_text(),
      'href': f'https://www.ptt.cc{link.get("href")}'
  } for link in links if '公告' not in link.get_text() ]
  wd.quit()
  return res

if __name__ == '__main__':
  res = get_ptt_board_list('movie')
  print(res)
Selenium 4.x 版本帶來了許多便利性的提升,尤其是在 WebDriver 管理和參數簡化方面。這對於減少教學備課的負擔以及提高自動化測試的效率都有很大的幫助。
我個人非常推薦升級至這個版本,以便能夠利用這些新的特性和優化。
在這篇文章中,將探討如何使用Python的PlayWright模組來抓取巴哈姆特動漫瘋的彈幕數據。 目標如下:
PlayWright 是Microsoft推出的開源專案,是一個Python用戶端,讓我們能夠自動化Web瀏覽器的行為,包括Chrome, Firefox, 和Safari等主流瀏覽器。你可以使用它來進行網站測試、抓取資料,甚至製作自動化的網頁腳本。透過PlayWright,你能控制整個瀏覽過程,包括產生彈幕等動態內容。
安裝PlayWright相當簡單,只需要在你的命令列工具 (例如:終端機或Command Prompt) 輸入以下命令即可:
> pip install playwright
首先,我們需要啟動一個PlayWright的實例,並且以我們選定的瀏覽器來執行我們的程式。以下是一個以Chromium瀏覽器為例的程式碼,同理也可以使用webkit瀏覽器:
> python -m playwright codegen -b chromium
執行上述命令後,您將開啟一個Chromium瀏覽器並開始與其互動。你的每一個操作,都會自動生成對應的Python程式碼。
codegen命令包含一些可用的參數,例如:
--target: 設定你的程式語言,如 python、JavaScript等。-o: 指定存放生成程式碼的檔案名稱。-b: 選擇你想要使用的瀏覽器,如 chromium、firefox或webkit。以下是一個實際的例子,使用webkit瀏覽器抓取巴哈姆特動漫瘋網站並將程式碼儲存在damun.py文件中:
> python -m playwright codegen --target python -o damun.py -b webkit https://ani.gamer.com.tw/
此時的damun.py內容參考如下:
from playwright.sync_api import Playwright, sync_playwright
from bs4 import BeautifulSoup
import json
import sys
import time


def run(playwright: Playwright, sn) -> None:
    browser = playwright.chromium.launch(headless=False)
    context = browser.new_context()
    page = context.new_page()

    page.goto(f"https://ani.gamer.com.tw/animeVideo.php?sn={sn}")
    time.sleep(5)

    # screenshot
    page.screenshot(path='ani.jpg', full_page = True)

    ### 稍後加上網頁解析
    ### 稍後加上內容萃取
    ### 稍後加上資料儲存

    page.close()

    # ---------------------
    context.close()
    browser.close()


with sync_playwright() as playwright:
    run(playwright, sys.argv[1])
為了包含抓取後的解析及整理,可以在前面透過點選產製的damun.py腳本中,新增解析的程式
網頁解析: page內容為HTML,將其轉換成BeautifulSoup物件,方便後續操作。
from bs4 import BeautifulSoup

soup = BeautifulSoup(page.content(), 'lxml')
內容萃取: 這邊藏的一個很關鍵的做法,用For迴圈直接將結果設計為JSON like的Python Dictionary格式。
# for-loops
res = []
k = {}
for li in soup.select('.sub-list-li'):
    k['userid'] = li.select_one('.name > span').text.strip()
    k['text'] = li.select_one('.sub_content').text.strip()
    k['msg_time'] = li.select_one('b').text.strip()
    print(k)
    res.append(k)
    res = [ {
        'userid': li.select_one('.name > span').text.strip(),
        'text' : li.select_one('.sub_content').text.strip(),
        'msg_time' : li.select_one('b').text.strip()
    } for li in soup.select('.sub-list-li')]
資料儲存: 將Dict樣式存成JSON格式,方便後續運用。
import json

with open(f'damun_{sn}.json', 'w') as f:
    json.dump(res, f)
最終的damun.py腳本內容:
from playwright.sync_api import Playwright, sync_playwright
from bs4 import BeautifulSoup
import json
import sys
import time


def run(playwright: Playwright, sn) -> None:
    browser = playwright.chromium.launch(headless=False)
    context = browser.new_context()
    page = context.new_page()

    page.goto(f"https://ani.gamer.com.tw/animeVideo.php?sn={sn}")
    time.sleep(5)

    # screenshot
    page.screenshot(path='ani.jpg', full_page = True)

    # 網頁解析
    soup = BeautifulSoup(page.content(), 'lxml')

    # 內容萃取(列表推導式)
    res = [ {
        'userid': li.select_one('.name > span').text.strip(),
        'text' : li.select_one('.sub_content').text.strip(),
        'msg_time' : li.select_one('b').text.strip()
    } for li in soup.select('.sub-list-li')]

    print(res)


    # 資料儲存(JSON檔)
    with open(f'damun_{sn}.json', 'w') as f:
        json.dump(res, f)

    page.close()

    # ---------------------
    context.close()
    browser.close()
    return res


with sync_playwright() as playwright:
    run(playwright, sys.argv[1])
接下來,執行我們生成的腳本,可以在命令列執行腳本。
33846為動畫的編號,可以更換成想要分析的動畫序號。
> python damun.py 33846
然後,使用Python的ast模組將結果轉換為Python對象。以下是一個實際的例子:
# 此欄位內容於ipynb執行
res = ! python damun.py 33846
import ast
res = [ast.literal_eval(i) for i in res]
print(res)
page.json有兩種方式可以將我們獲得的結果儲存為json格式。一種方式是使用linux的命令行將結果重定向到一個json檔案中。例如:
> python damun.py 33846 > page.json
另一種方式是直接在Python腳本中將結果儲存為json檔案。以下是一個實際的例子:
import json

file_name = 'damun_33846.json'

with open(file_name, 'r', encoding='utf-8') as f:
    my_data = json.loads(f.read())

    print(my_data)

    print(type(my_data))
解析的結果為:

擷取完成!
在上述的Python腳本中,首先定義了我們的檔案名稱。然後,我們使用Python的內建函數open讀取該檔案。最後,我們使用json模組的loads函數將讀取到的資料轉換為Python物件。
以上就是如何使用PlayWright抓取並分析巴哈姆特動漫瘋的彈幕數據的全過程。透過這個過程,我們不僅學習到如何使用PlayWright,如果有興趣,後續再介紹如何進一步分析數據,歡迎留言讓我知道。
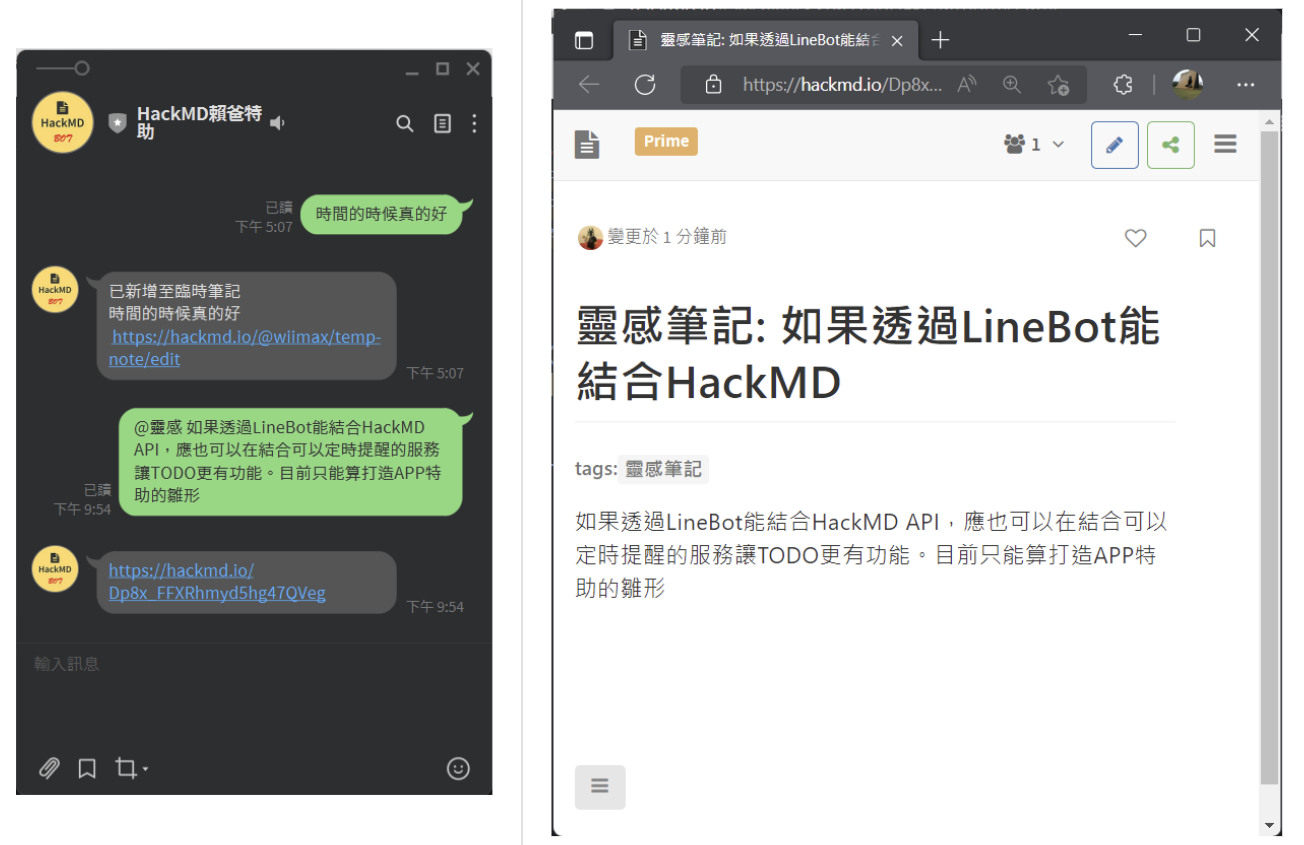
https://[APP Name].fly.io/callback填入您LINE Channel 的 Webhook。LINE Chat BOT程式碼標示@靈感為開頭的文字,將作為一個獨立的靈感筆記。
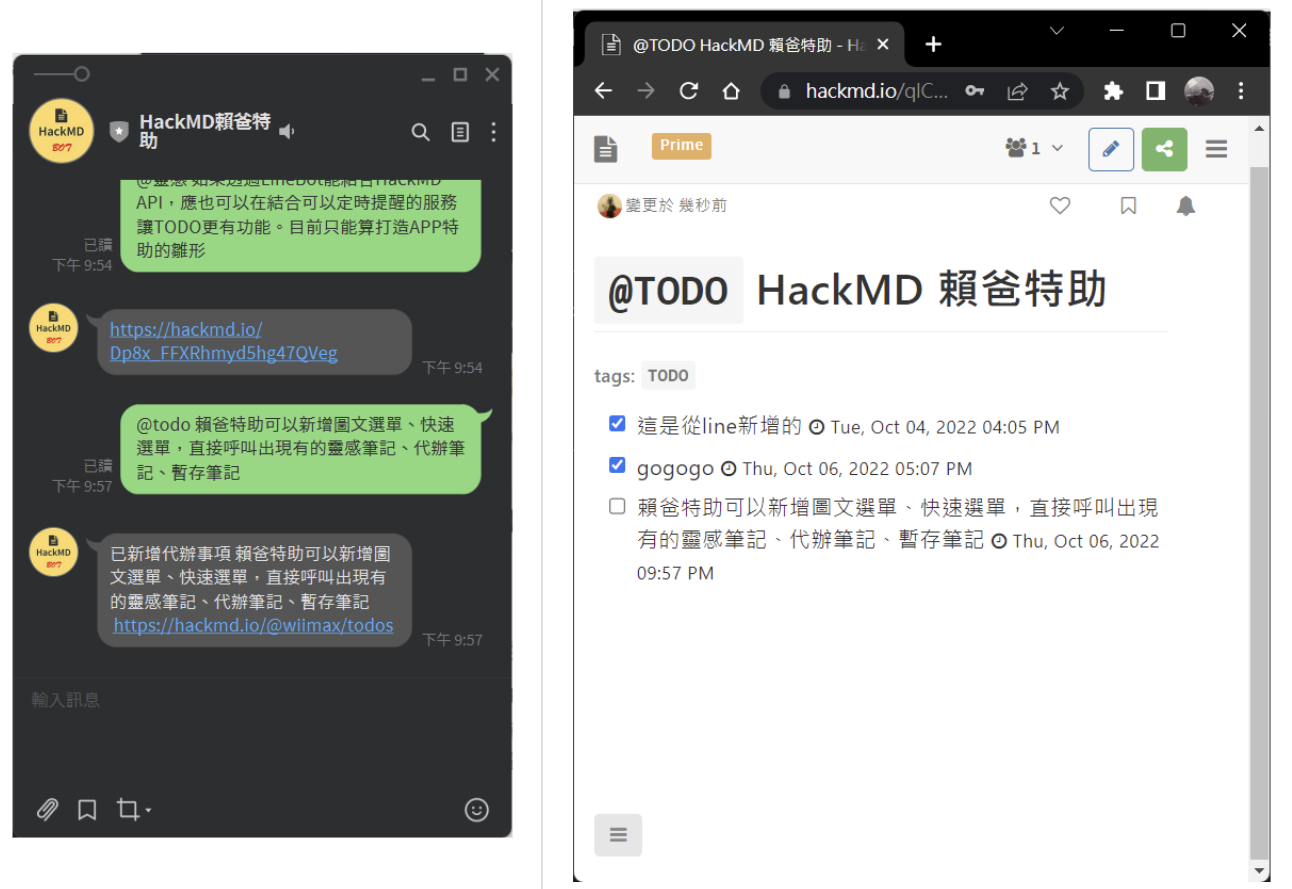
標示@TODO為開頭的文字,將寫入一個連續的的代辦清單。
無上述標示的文字,將寫入一個連續附加的在暫存筆記。也就是從別的文章分享的超連結都直接灌到此暫存筆記。
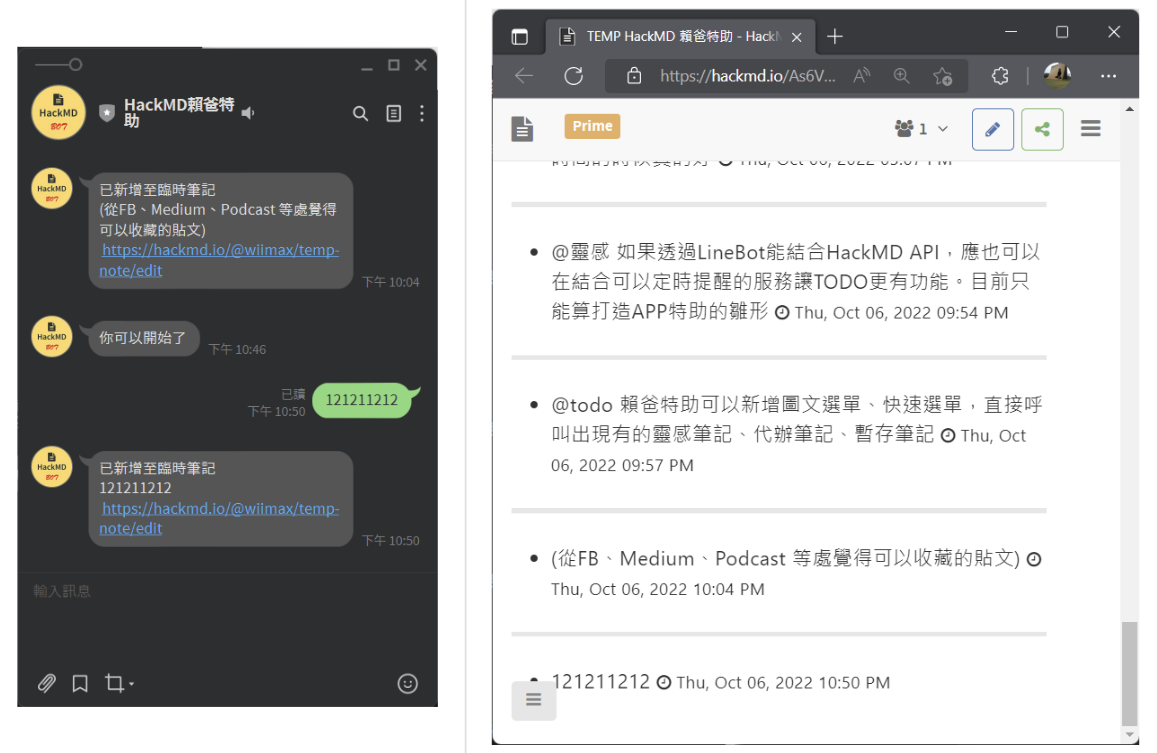
如果要整理筆記,用電腦編輯整理即可。
:::spoiler 部署教學文參考
在 LINE Developers 登入您的 LINE 帳號,建立 Provider 以及所屬 Channel, Channel 名稱就是您的 LINE bot 名稱,管理方式如同 LINE 官方帳號。
用程式控制的聊天機器人需要以下3個參數,請保管好勿外流。
在此範例程式中,需要將 Channel 查到的以下參數填入config.py檔案。
CHANNEL_ACCESS_TOKEN = ''
CHANNEL_SECRET = ''
LINE_USER_ID = ''
在本機電腦安裝git,您可以先完成以下示範範例後,再將程式碼改成LINE Chat BOT程式碼即可。
git clone https://github.com/fly-apps/python-hellofly-flask
進入專案資料夾
cd .\python-hellofly-flask\
安裝該專案所需的外部套件
python -m pip install -r requirements.txt
[選用] 如果要在本機進行開發測試,可以設置環境變數FLASK_APP,目的是指定主程式的執行檔,對此專案而言主程式為hellofly.py,經指定後flask run指定就是跑主程式,而且要結合 Ngrok建立臨時通道,對您來說太複雜的話可以跳過,只是各種測試就必須等待部署後。
//設置環境變數
export FLASK_APP=hellofly.py   #linux
set FLASK_APP=hellofly.py   #windows
//日後啟動flask的指令
flask run
!! 如果用環境變數都跑不出來,退而求其次,在hellofly.py最後加入:
if __name__ == '__main__':
    app.run(debug=True)
啟動flask指令改為python hello.py,請注意,這不是flask現在建議的啟用方式,本方法只適用於本機測試。
fly ctl 指令工具完成部署上述範例程式碼測試無誤後,接續安裝 fly ctl 指令工具。Fly.io 最方便部署服務的方式是使用終端機指令工具flyctl,可以讓本機直接部署。
安裝flyctl
PowerShell
iwr https://fly.io/install.ps1 -useb | iex
Mac
brew install flyctl #MAC
Linux
curl -L https://fly.io/install.sh | sh #LINUX
flyctl auth login
啟動一個 fly App 專案,執行 flyctl launch
flyctl launch
選擇伺服器區域,台灣鄰近的區域有香港、東京可選。
修改程式,這邊在範例專案中特別提醒,Procfile檔案為設定連線服務用,與您的主程式檔名務必相符,也就是原本為web: gunicorn server:app記得改成web: gunicorn hellofly:app,這原理跟部署在 Heroku 是一樣的。
# file name: Procfile

web: gunicorn hellofly:app
              ^^^^^^^^記得確認為主程式
檢查完程式後,一鍵佈署。
flyctl deploy
查看佈署,其中hostname就是網址了,可以用flyctl status確認狀態、用flyctl open開啟 APP、用flyctl logs確認有無 BUG。
flyctl status
flyctl open
flyctl logs
如果需要設定 secrets
flyctl secrets set DATABASE_URL= ....
取消 secrets
flyctl secrets unset DATABASE_URL= ....
列出 secrets list
flyctl secrets list
LINE Chat BOT程式碼可以對照您上述部署完成的python-hellofly-flask程式碼進行修改,
config.pyapp.pyrequestments.txt執行flyctl deploy部署。請注意,*.toml請用您自己的,該檔案是由 flyctl launch 產生,為了您的專案部屬所需的檔案,用範例檔會出錯唷。
也請記得補上 HackMD API token 與筆記ID相關資訊:
HACKMD_API_TOKEN = ''
TODO_NOTE_ID = '' #  paste your fixed TODO note id, len == 22
TEMP_NOTE_ID = '' # paste your fixed TEMP note id, len == 22
上述有問題的話就耐心看flyctl logs,我常作的方式是開兩個終端機,一個執行操作、一個看 log 。
部署完成後,記得把您的 fly.io 專屬服務網址貼入 LINE Channel 的 Webhook ,網址應為 https://[APP Name].fly.io/callback ,特別是 */callback 記得填,並且設定開啟 Webhook。
恭喜您完成!
六角學院是台灣前端知名的線上教學服務平台,這次已非常少的售價開設了短期密集軟工體驗營,體驗的內容包含前端基礎、CSS、SCSS、切版任務、JS、Jquery、Ajax、Axios,在這次的體驗營中,我們在有限的時間內接觸了相當多的課程內容。這些線上影音很多是不同的直播、教學課程的集合。真的讓我感到既驚訝又欣喜!🎉
除了假日以外,每日我們都有關於切版、JS的兩種練習。最後,這些練習都會回到產出作業上,讓我們有機會將所學應用到實際操作中,真的是學以致用!💡📝
在產出作業的過程中,作業等級越高越完整。而這其中,最讓我感動的是有助教群細心審視我們的作業並提供回饋。這樣的機會真的非常難得,我們能夠從中學習到很多,進步也就在這一點一滴中實現。👍👏
最後,也很感謝能夠在課程提問區提出問題,並透過交流討論來解答疑惑,慢慢走也是會往前的😊🐢
總結來說,我真的很感謝六角學院提供這樣的體驗機會。從中我學習到很多,並且在學習的道路上也逐步累積。期待下一次的學習體驗!🎈🚀
你有沒有聽過亞當斯密的「看不見的手」?這是一個經濟學的名詞,指的是市場機能能夠自動調節供需,讓每個人都能追求自己的利益,同時也促進社會的福祉。聽起來很神奇,但是這個「看不見的手」其實有一個隱藏的秘密,那就是它其實是一隻「ESG」的手!今天我想和大家聊聊亞當斯密的"看不見的手"和ESG之間的關係。😊
ESG是環境、社會和治理(Environmental, Social and Governance)的縮寫,它是一種評估企業對社會責任和可持續發展的影響的方法。ESG涵蓋了許多方面,例如減少碳排放、保護生物多樣性、改善勞工權益、反對貪腐和提高透明度等。🌎
近年來,ESG越來越受到投資者、消費者和政策制定者的重視,因為它不僅關係到企業的道德和聲譽,也關係到企業的長期競爭力和風險管理。許多研究表明,高ESG表現的企業往往能夠創造更高的股東價值、更低的資金成本、更強的創新能力和更高的員工忠誠度。💰
"看不見的手"是一個出現在經濟學之父亞當斯密的《國富論》和《道德情操論》中的一個詞彙,它指的是在自由市場中,每個人追求自己的利益,通過價格機制,最終會促進社會整體的福利,就像有一隻看不見的手在指導經濟活動一樣。👋
舉個例子,假設你想買一個蘋果,你會在市場上找到最便宜的蘋果賣家,而賣家則會根據供需關係設定一個合理的價格,這樣你們雙方都能得到最大的滿足。同時,這也會刺激其他蘋果生產者提高產量和品質,降低成本和價格,從而增加社會的總產出和消費。🍎
你可能會覺得"看不見的手"和ESG是相互對立的概念,因為前者強調市場自由和個人利益,後者強調社會責任和公共利益。但其實,它們之間並不是那麼簡單的對立關係,而是有著複雜而微妙的互動。😉
首先,亞當斯密在他的另一本著作《道德情操論》中,提出了一個重要的概念,那就是「同情心」(sympathy)。他認為人類是一種社會性的動物,具有與他人共感和同理的能力,這種能力讓我們能夠關心他人的利益和幸福,也讓我們能夠遵守道德規範和社會規則。這不就是ESG中的「社會」嗎?
你可能會問,那他怎麼沒有提到「愛心」(love)呢?因為他知道愛情是盲目的,而市場是明智的!(笑)
其次,亞當斯密在他的《國富論》中,也沒有忽視環境問題。他指出了農業對土地資源的消耗和浪費,並且主張應該通過稅收來抑制農業生產過剩和土地荒廢。他還提出了「公共工程」(public works)的概念,認為政府應該負責建設和維護基礎設施,如道路、橋樑、港口等,以促進交通和貿易,也以保護環境和公共安全。這不就是ESG中的「環境」嗎?
你可能會問,那他怎麼沒有提到「節約」(save)呢?因為他知道節約是美德,但消費才能帶動經濟!(笑)
最後,亞當斯密在他的《國富論》中,也強調了治理問題。他批判了當時英國政府對商業和貿易的過度干預和限制,例如重商主義政策、商業壟斷、關稅壁壘等。他主張政府應該放寬市場准入,保護私有財產權和契約自由,打擊貪污和腐敗,保障法治和司法公正。這不就是ESG中的「治理」嗎?
你可能會問,那他怎麼沒有提到「民主」(democracy)呢?因為他知道民主是好事,但市場才是王道!(笑)
所以你看,亞當斯密其實是一個ESG的先驅!他不僅提出了「看不見的手」這個偉大的經濟學思想,也提出了「ESG」這個偉大的企業社會責任思想!我們今天所看到的市場經濟和企業社會責任,都是他留給我們的寶貴遺產!。😊
感謝大家閱讀我的部落格文章,如果你有任何意見或建議,歡迎在下面留言或聯絡我。下次再見!👋 (本文笑點提供: Bing)

如果你是一個 Docusaurus 使用者,你可能已經知道如何使用 Github Pages 部署你的網誌。但是,手動更新並部署你的網誌非常耗時,而且容易出錯。為了解決這個問題,你可以使用 GitHub Actions 來自動生成和部署你的網誌,這樣你就可以專注於撰寫新的文章了。
GitHub Actions 是一個自動化工具,可以幫助你自動執行各種任務,例如建立和測試你的應用程序,將你的應用程序部署到不同的環境中,或者自動發佈你的網誌文章。你可以使用 GitHub Actions 的預設工作流程,或者創建自己的自訂工作流程。
下面是一個簡單的步驟,可以幫助你在 GitHub Actions 中自動生成和部署你的 Docusaurus 網誌。
在你的 Docusaurus 存儲庫中,創建一個名為 .github/workflows/deploy.yml 的文件。
在 deploy.yml 文件中添加以下內容:
name: Deploy website
on:
push:
    branches:
    - main
jobs:
deploy:
    runs-on: ubuntu-latest
    steps:
    - uses: actions/checkout@v2
    - name: Install Node.js
    uses: actions/setup-node@v1
    with:
        node-version: '14.x'
    - name: Build and deploy
    uses: JamesIves/github-pages-deploy-action@4.1.3
    with:
        branch: gh-pages
        folder: build
        clean: true
這個工作流程會在主分支上進行 push 時運行。它會在最新的 Ubuntu 環境中運行,安裝 Node.js,構建你的 Docusaurus 網誌,然後將它部署到 gh-pages 分支。
在你的 Docusaurus 存儲庫中,建立一個名為 build 的文件夾。
執行以下命令,生成你的 Docusaurus 網誌:
npm run build`
這將在 build 文件夾中生成編譯後的靜態網頁。
執行以下命令,將你的更改提交到存儲庫中:
git add .
git commit -m "Update website"
git push
這會觸發 GitHub Actions,自動生成和部署你的 Docusaurus 網誌。你可以在 GitHub Actions 的頁面上查看進度和結果。如果一切順利,你的網誌應該已經部署到 gh-pages 分支中。
https://yourusername.github.io/yourblog/。如果一切正常,你應該能夠看到你的網誌文章。現在你已經成功地使用 GitHub Actions 自動部署了你的 Docusaurus 網誌,接下來你可能想要優化你的網誌的 SEO,以便更好地吸引流量和讀者。以下是一些簡單的技巧,可以幫助你優化你的網誌的 SEO。
在你的網誌文章的標題和內容中使用關鍵字,以便搜索引擎能夠更好地理解你的內容,並將其排名更高。但是,不要過度使用關鍵字,否則你的內容可能會被搜索引擎視為垃圾郵件。關鍵字優化的訣竅是參考Google搜尋結果的相關搜尋,將相關搜尋的文章進一步整理為合適的內容,讓讀者能在這一篇文章就可以滿足需求。
創建有價值的內容是吸引讀者和排名更高的關鍵。寫出具有深度和價值的內容,以便讀者和搜索引擎都能夠看到你的專業知識和價值,自己的洞見非常重要,讀者不會想只看到類似 ChatGPT 生成的大量文章。
使用適當的標記和元數據,例如標題標記、描述標記和關鍵字標記,以幫助搜索引擎更好地理解你的內容。同時,使用適當的元數據,例如 Open Graph 協議和 Twitter 卡片,以使你的內容在社交媒體上分享時更有吸引力。
使用友好的 URL,以便讀者和搜索引擎更好地理解你的內容。使用有意義的字詞和短條目,避免使用難以理解的符號和數字。同時,使用靜態 URL,以便搜索引擎可以更輕鬆地索引你的網站。
優化你的網站的速度和性能,以便更好地吸引流量和提高排名。使用快速的網站主機和優化的圖像,避免使用過多的 JavaScript 和 CSS,以減少網站的加載時間。同時,使用快取和網站緩存,以便減少服務器負載並提高網站的速度。
建立高質量的內部和外部連結,以幫助搜索引擎更好地理解你的內容並提高你的排名。使用有意義的錨文本和鏈接到相關的內容,同時建立高質量的外部鏈接,以提高你的網站的權威性和排名。
監測和分析你的網站的流量和排名,以了解你的目標讀者是誰,以及他們如何找到你的內容。使用 Google Analytics 或其他分析工具來跟踪你的流量和排名,並根據這些數據調整你的 SEO 策略。
使用 GitHub Actions 自動部署你的 Docusaurus 網誌是一個簡單而有效的方式,可以幫助你更輕鬆地管理和更新你的網誌。同時,優化你的網誌的 SEO 是一個重要的步驟,可以幫助你吸引更多的流量和讀者,並提高你的排名。遵循上述的技巧和策略,你可以建立一個成功的網誌,吸引更多的讀者和流量,並在搜索引擎上排名更高。


在這個範例,您只要兩個步驟就可以完成囉:
 ,一鍵執行以下程式碼,程式跑完會出現3個連結,點選第2個連結會開啟新分頁,是生圖的 UI 介面。


8k, RAW photo, best quality, masterpiece:1.2), (realistic, photo-realistic:1.4), ultra-detailed, (Kpop idol),perfect detail , looking at viewer,make up,
paintings,sketches, (worst quality:2), (low quality:2), (normal quality:2), lowres, normal quality, ((monochrome)), ((grayscale)), skin spots, acnes, skin blemishes, bad anatomy,(long hair:1.4),DeepNegative,(fat:1.2),facing away, looking away,tilted head, {Multiple people}, lowres,bad anatomy,bad hands, text, error, missing fingers,extra digit, fewer digits, cropped, worstquality, low quality, normal quality,jpegartifacts,signature, watermark, username,blurry,bad feet,cropped,poorly drawn hands,poorly drawn face,mutation,deformed,worst quality,low quality,normal quality,jpeg artifacts,signature,watermark,extra fingers,fewer digits,extra limbs,extra arms,extra legs,malformed limbs,fused fingers,too many fingers,long neck,cross-eyed,mutated hands,polar lowres,bad body,bad proportions,gross proportions,text,error,missing fingers,missing arms,missing legs,extra digit, extra arms, extra leg, extra foot,


如何使用 GitHub Pages 部署 Docusaurus,可以透過以下步驟,輕鬆地建立自己的網誌。
在開始之前,我們需要先確保以下條件都已經滿足:
首先,在 GitHub 上創建一個新的 Repository,用來存放網誌的代碼和部署文件。以下是創建 Repository 的步驟:
登錄 GitHub,進入主頁面。
點擊右上角的 “+” 按鈕,然後選擇 “New repository”。
在創建 Repository 的頁面中,填寫 Repository 名稱、描述和設置等信息,然後點擊 “Create repository” 按鈕創建 Repository。
接下來,我們需要下載 Docusaurus 的範本代碼,作為網誌的基礎。以下是下載 Docusaurus 範本的步驟:
npx @docusaurus/init@latest init my-blog classic
在下載 Docusaurus 範本之後,我們需要進行安裝和測試,以確保網誌可以正常運行。以下是安裝和測試 Docusaurus 的步驟:
進入 my-blog 文件夾,打開命令行工具。
輸入以下命令,安裝 Docusaurus 和相關的依賴:
npm install
安裝完成後,輸入以下命令,啟動 Docusaurus 的本地測試服務:
npm start
在 Github 上建立新的 repository
在 Github 上建立一個新的 repository,命名為 {username}.github.io,其中 username 是你的 Github 使用者名稱。例如,我的 Github 使用者名稱是 chatgpt,因此我會命名我的 repository 為 chatgpt.github.io。
將 Docusaurus 專案上傳至 Github
在你的電腦上開啟終端機(Terminal)或命令提示字元(Command Prompt),進入到 Docusaurus 專案的根目錄下,並執行以下指令:
git init
git remote add origin git@github.com:{username}/{username}.github.io.git
npm run build
npm run deploy
其中,username 是你的 Github 使用者名稱,請注意要改成你自己的。這些指令的作用如下:
git init:初始化 Git 儲存庫。git remote add origin git@github.com:{username}/{username}.github.io.git:設定 Git 儲存庫的遠端位置。npm run build:建立 Docusaurus 專案的靜態網頁檔案。npm run deploy:將靜態網頁檔案上傳至 Github。在執行 npm run deploy 的時候,會需要你輸入 Github 的使用者名稱和密碼(或是 Personal Access Token)。請輸入正確的資訊後,等待上傳完成。
檢查網站是否正常運作
完成上傳後,打開瀏覽器,輸入 https://{username}.github.io,其中 username 是你的 Github 使用者名稱,就可以看到你的 Docusaurus 網站了!如果你看到了你的網站,那就代表部署成功了。
編輯 Docusaurus 網站
現在,你可以開始編輯你的 Docusaurus 網站了。編輯完成後,只需要執行以下指令:
git add .
git commit -m "Update website"
git push origin main
其中,Update website 是你的提交訊息,你可以自己替換成任何訊息。執行這些指令後,你的修改就會自動更新到你的 Github Pages 上了。
以上使用 Github Pages 部署 Docusaurus 教學,希望能幫助到您。


